🏛️ 第08讲:为什么 Attention 算力没少算,FlashAttention 却能快 3 倍?——从 Decoder Block 算子图、RoPE 复数旋转到显存四账本的第一性原理
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 00: 性能工程与系统前置
篇章范式:📐 模型架构、算法与显存建模篇(Model Architecture & Memory Ledger Paradigm)
核心导读:你手里有一张 80GB 显存的 A100,输入 4096 长度的 Prompt,做一次 Attention 矩阵乘法只需要 0.05 秒;但一旦上下文拉长到 32K,显存瞬间像决堤的海啸一样暴涨 64 倍直接 OOM 炸机!更奇怪的是:后来出现的 FlashAttention 在数学上一次浮点运算都没少算(FLOPs 完全相同),为什么端到端速度却能暴涨整整 3~5 倍?
Attention 真正昂贵的,到底是算力,还是慢速 HBM 显存的数据搬运?
学习 Transformer 的终极目的,绝不是死记硬背公式,而是建立起清晰的数据流动直觉(Tensor Flow)、算力与显存账本(Arithmetic & Memory Ledger) 与 底层硬件执行心智模型(Hardware Execution Mapping)。从前向 GEMM 矩阵乘法到反向梯度回传,从 的 Attention 显存海啸到 FlashAttention 的片上 SRAM 算子融合,从 MHA 到 GQA 的 KV Cache 显存瘦身,从绝对位置编码到 RoPE 的 2D 复数旋转魔术——每一个看似精妙的算法改进,背后都深刻交织着计算机体系结构的算力受限(Compute-Bound)与带宽受限(Memory-Bound)的物理博弈!
本讲我们将彻底告别死板的数学堆砌,用极客大白话与手把手推导,拆透 Transformer 的每一颗齿轮与每一个张量 Shape,带你亲手白板手算出 7B/70B 模型的全部参数与显存四账本!
📑 目录导航
- 0. Ringi 开场:不懂 Transformer 的 AI Infra 工程师,就像闭眼调校 F1 赛车发动机
- 1. Transformer 架构全貌与演进第一性原理
- 2. Self-Attention 机制与数学/算子级微观拆解
- 3. 前馈网络(FFN)——大模型的深度特征加工厂
- 4. 位置编码(Position Encoding)——赋予序列时空坐标
- 5. 归一化与残差连接——深层网络的定海神针
- 6. 完整的 Transformer Decoder Block 组装与全流程张量 Shape 流动表
- 7. 从 Transformer 到 LLM 推理:自回归生成与 KV Cache 革命
- 8. 动手实战与代码实验室(Minimal Runnable Code)
- 9. Ringi 避坑指南与大厂硬核经典面试题
- 10. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 11. 📚 参考资料与经典开源实现源码指引
0. Ringi 开场:不懂 Transformer 的 AI Infra 工程师,就像闭眼调校 F1 赛车发动机
0.1 汽车发动机比喻与大厂实战痛点
如果你立志成为一名优秀的 AI Infrastructure(AI 基础设施)工程师——无论你是在底层死磕 CUDA C++ / Triton 算子编写、在千卡集群中调试 Megatron-LM / DeepSpeed 分布式并行流水线,还是在负责 vLLM / TensorRT-LLM 高并发推理服务的显存架构设计——你天天打交道的核心工作对象都是同一个东西:Transformer 模型。 这就像赛车工程师必须精通 F1 赛车内燃机的机械构造一样:- 你不需要每天自己去重新画图发明一个全新的气缸结构(那是顶级算法科学家和架构师的工作);
- 但你必须对活塞怎么往复运动、曲轴转速多少、火花塞何时点火、高压油泵的供油压力曲线了如指掌!
- 如果你连 投影矩阵在显存中的步长 Strides 都不清楚,连注意力矩阵为什么在长文本下会导致显存爆炸都无法手算,那你写出来的 CUDA Kernel 必定频频遭遇非合并访存(Uncoalesced Access)和内存踩踏,调出来的分布式训练系统也必定会在几十个节点处发生严重的通信阻塞(Pipeline Bubble)。
0.2 线上真实惨案:70B 模型在长文本下的显存海啸与算力坍缩
在大厂参与千亿大模型预训练与生产推理集群搭建时,我曾见过无数起因对 Transformer 底层物理机制理解不清而引发的惨烈事故:- 惨案 A(训练端 OOM 爆炸):算法同学在单台 8 卡 A100-80GB 服务器上训练 7B 模型,静态权重(FP16)只有 14GB,梯度 14GB,ZeRO-1 优化器分摊后只要 10.5GB,看似总共只要 38.5GB 显存。然而当他把 Sequence Length 从 2048 调到 8192 时,第 1 个 Step 前向尚未走完,显存直接飙升突破 80GB 瞬间 OOM!原因:未开启重计算与 FlashAttention,多层 Attention 产生的 激活值(Activation)在显存中扣留了高达 50GB 以上的中间张量!
- 惨案 B(推理端算力崩塌):推理业务上线 LLaMA-70B 服务,在用户输入长 Prompt(Prefill 阶段)时,GPU 利用率高达 95%,速度飞快;然而一旦进入逐字吐词(Decode 阶段),单卡的 GPU 利用率瞬间暴跌至 8%~15%,整个系统 85% 以上的时间全在等待 HBM 显存带宽搬运,算力严重饥饿!
0.3 AI Infra 各层级技术与 Transformer 模块对应全景图
AI Infra 领域每一项声名赫赫的硬核优化技术,都能在 Transformer 架构中找到它精确作用的物理节点与数学算子:1. Transformer 架构全貌与演进第一性原理
1.1 原始 Transformer:Encoder-Decoder 架构的双向与交叉注意力
2017 年 Google 团队在划时代论文 《Attention Is All You Need》 中提出了最初的 Encoder-Decoder(编码器-解码器) 结构:- Encoder(编码器):采用双向全向自注意力(Bidirectional Attention)。对于输入的句子,每一个 Token 都可以同时看到句子中位于自己前面和后面的所有 Token,核心职能是高维语义特征的抽取与理解;
- Decoder(解码器):包含两层注意力——掩码因果注意力(Masked Causal Attention)(确保生成第 个词时只能看到前 个词)+ 交叉注意力(Cross-Attention)(以 Decoder 自身的中间特征作为 Query,向 Encoder 的输出索要 Key 和 Value),核心职能是序列到序列的条件概率生成(Seq2Seq)。
1.2 当前大模型统一霸主:为什么是 Decoder-only 架构?
从 OpenAI 的 GPT 系列,到 Meta 的 LLaMA、Mistral,再到国内的 Qwen(千问)与 DeepSeek,现代大语言模型几乎 100% 统一采用了 Decoder-only 架构。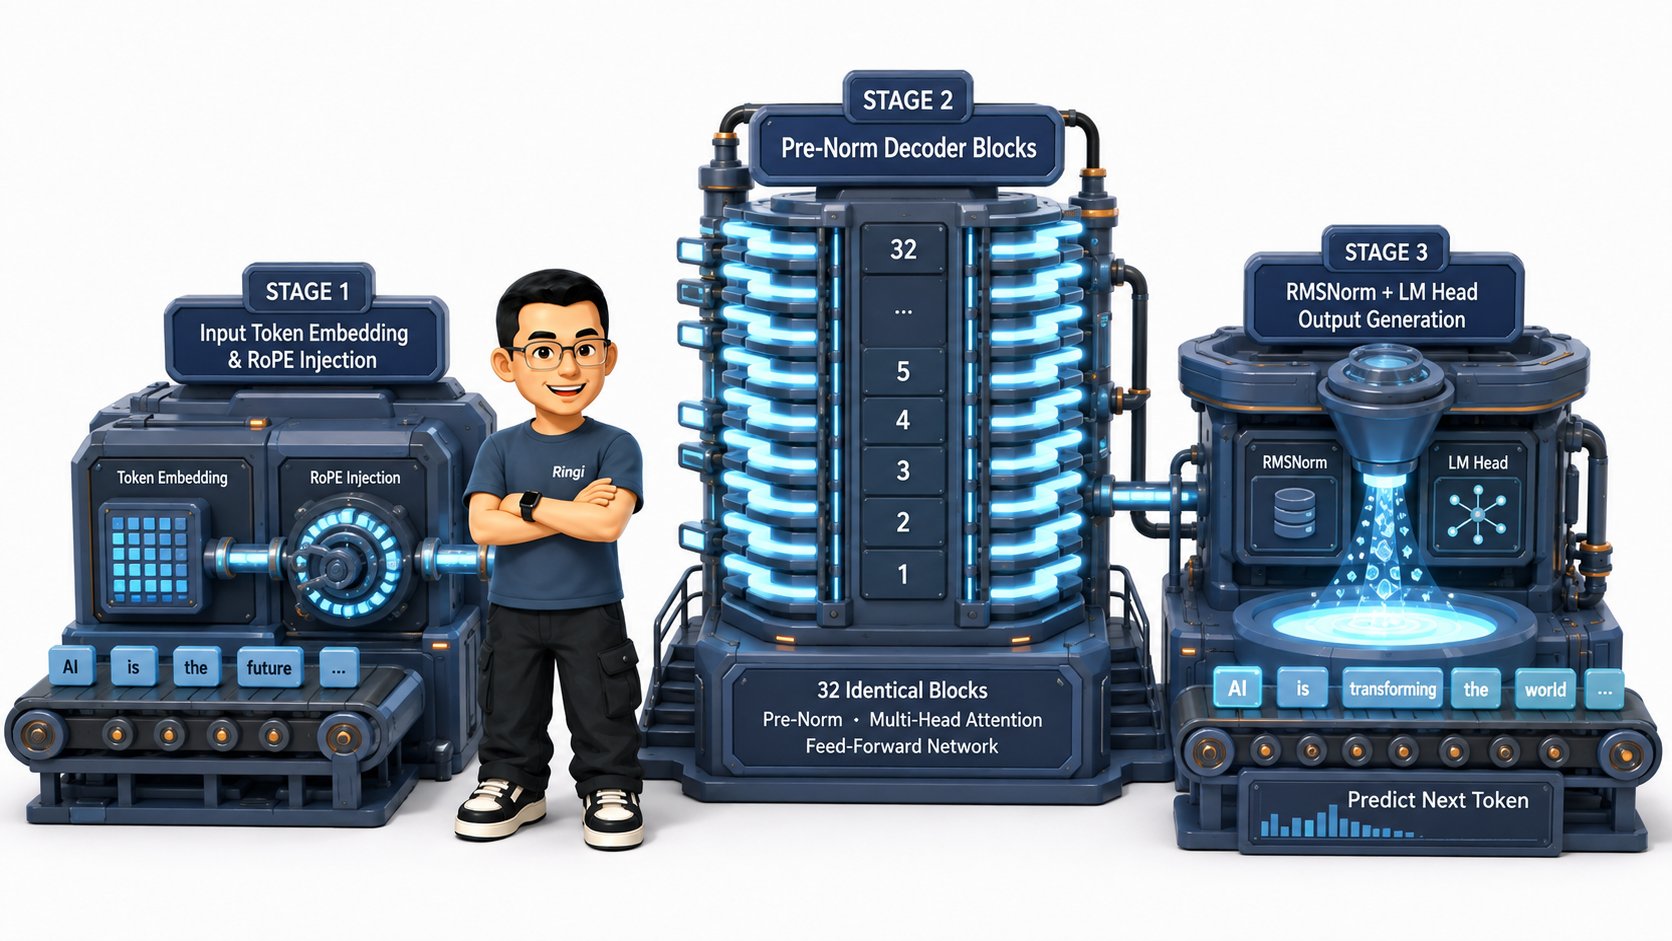
💡 Ringi 第一性原理思考:为什么 Decoder-only 能横扫整个 AI 工业界?
- 统一的自回归训练范式(Next-Token Prediction):
在现代大模型哲学中,人类的所有智能任务(文本翻译、代码编写、数学推理、逻辑对话、甚至多模态视觉生成)本质上都可以被统一表达为**“给定上文,预测下一个最具概率的 Token”**。Decoder-only 架构天然契合因果掩码生成,无需像 Encoder-Decoder 那样在不同任务间做复杂的编码器-解码器交互协调;- 工程实现与分布式调度的极致优雅:
在 Decoder-only 架构中,全网只有一种标准统一的 Decoder Block。这意味着:
- 显存分配器无需管理两套异构的 KV 缓存池;
- Megatron-LM 的张量并行切分规则在所有层完全一致;
- 流水线并行(PP)各个 Stage 的计算负载能够做到完美的对称均衡,绝不会出现 Encoder 与 Decoder 算力倾斜导致的严重气泡等待!
经典三段式数据流动流程:
- 输入阶段(Input Stage):
- 核心堆叠阶段(Repeated Blocks):
- 输出阶段(Output Stage):
1.3 三大架构变体(Encoder-only, Encoder-Decoder, Decoder-only)深度横评
2. Self-Attention 机制与数学/算子级微观拆解
Self-Attention(自注意力机制)是 Transformer 最核心的计算引擎,也是算力消耗与显存占用的最大来源。2.1 直觉理解:图书馆查资料与信息加权聚合
我们先用一个生动的生活例子建立物理直觉: 假设你是一位正在写论文的研究员,走进了一座巨大的图书馆:- 你手里拿着一张写着你研究课题的借书清单——这就是 Query(提问/需求);
- 图书馆里每一本书的书脊上都贴着分类索引标签(如“机器学习”、“操作系统”、“经济学”)——这就是 Key(索引标牌);
- 每一本书里面的具体章节内容和核心知识——这就是 Value(真正的内容载荷)。
2.2 的物理意义:同一个 Token 的三副眼镜
在 Self-Attention 中,输入序列中的每个 Token 本质上都通过三组不同的可学习线性权重矩阵,同时被赋予了三种截然不同的身份: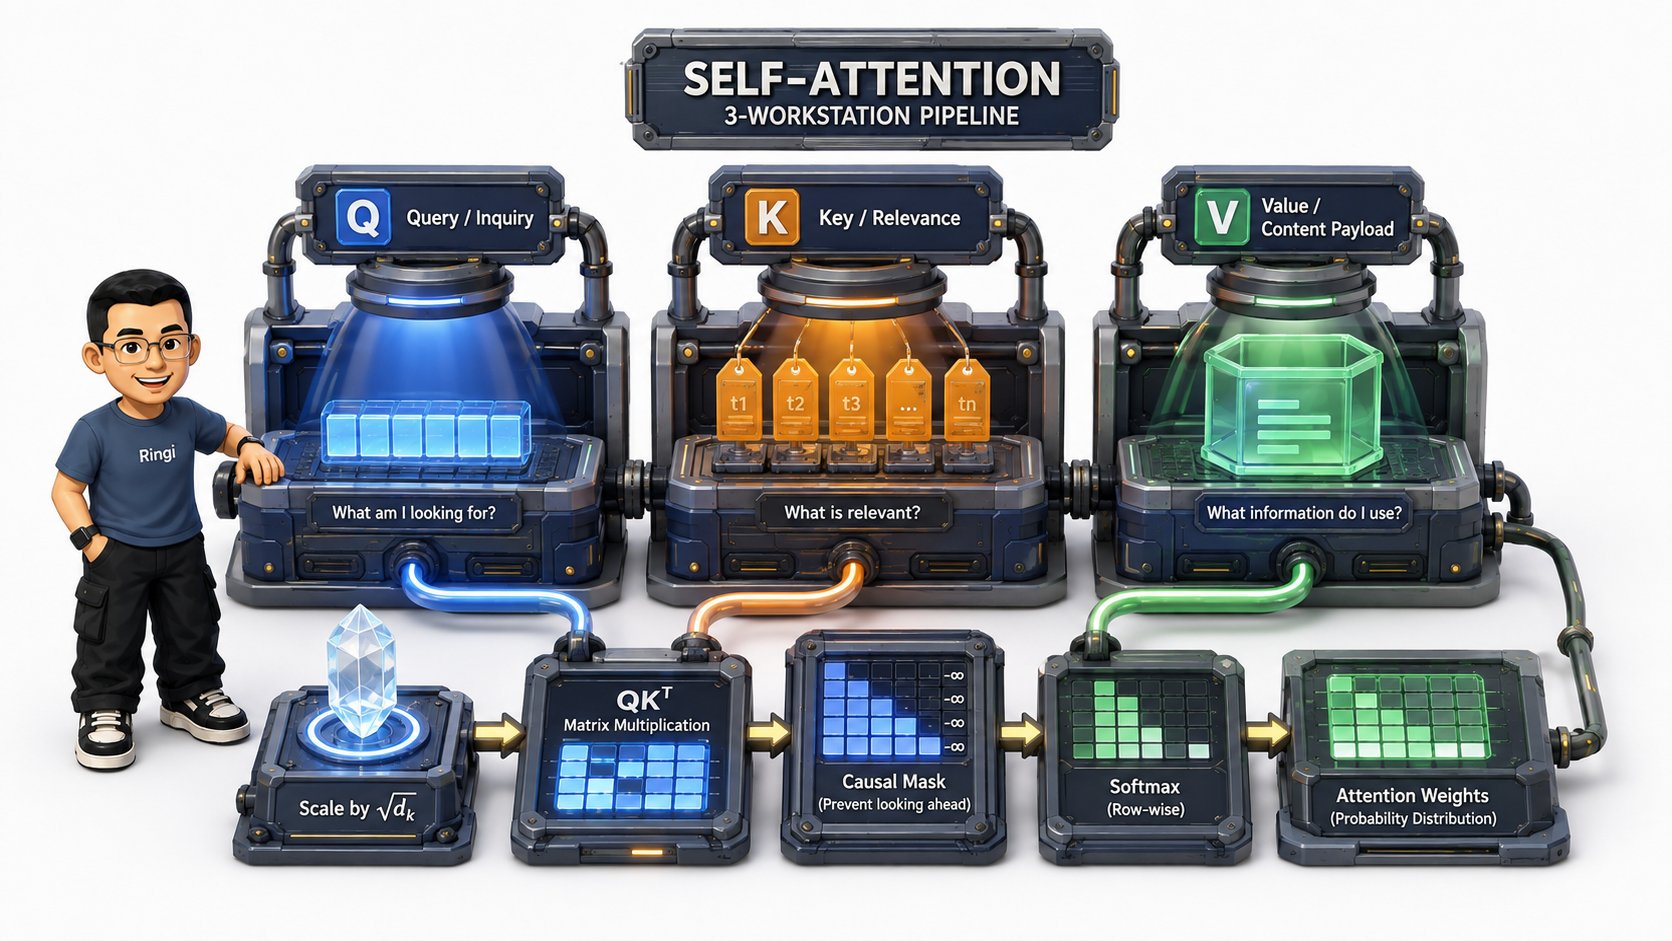
- Query ():提问者身份,发出检索需求(例如:“我是动词‘吃’,我在找我的主语和宾语是谁?”);
- Key ():索引标牌身份,用于被别人的 Query 检索匹配(例如:“我是名词‘苹果’,我是可以被吃的水果”);
- Value ():真实信息载荷,匹配成功后贡献给其他 Token 的实际特征(例如:“提供关于‘苹果’的完整语义向量”)。
2.3 6 步逐步推导与手把手数字算盘(GEMM 打分 缩放 掩码 Softmax 输出)
设输入张量为 ,其中 为批大小(Batch Size), 为序列长度(Sequence Length), 为隐藏层维度(Hidden Dimension)。为了便于小白理解,我们暂时省略 Batch 维度,考察单个序列 。步骤 1:线性投影生成 (3 次标准 GEMM)
通过三个参数矩阵 将输入投影为三组向量:- Tensor Shape: 形状均为 ;
- FLOPs 计算量:每个投影执行一次标准矩阵乘法,单次 GEMM 计算量为 FLOPs,三次总计为 FLOPs;
- GPU 机器底层:由 cuBLAS / CUTLASS 驱动的 Tensor Core 极速矩阵乘法内核执行。
步骤 2:计算原始注意力打分矩阵( )
计算序列中任意两个 Token 之间的点积相似度:- Tensor Shape: ;
- 物理意义: 表示第 个 Token 的 Query 与第 个 Token 的 Key 之间的向量内积。
🔢 手把手极简数字算盘:
设某个 Token 的 ,另一个 Token 的 ,则点积为: 两向量夹角越小、方向越一致,点积越大,代表注意力打分越高。步骤 3:缩放因子(Scaling)——为什么必须除以 ?
其中 为单个注意力头的维度(如 )。步骤 4:因果掩码(Causal Masking)与 Softmax 归一化
为了保证模型在自回归生成时不能“偷看未来的词”,必须加入上三角掩码矩阵 : 随后对每一行执行 Softmax 归一化:- 因为 ,未来位置在 Softmax 后的注意力权重严格为 0;
- 矩阵 的每一行所有元素非负且和严格等于 1:
步骤 5:加权求和(用注意力概率聚合 Value 特征)
- Tensor Shape: ;
- 物理意义:第 个 Token 的输出向量,就是整篇序列中所有 Token 的 按照第 行权重概率分布 进行加权线性求和。
步骤 6:输出线性投影(Output Projection)
通过可学习参数矩阵 对所有头聚合的信息进行最终的特征融合整理。🏆 终极标准自注意力公式
2.4 为什么缩放因子必须除以 ?方差发散与 Softmax 饱和梯度消失的数学证明
很多同学在面试中经常被问到:“为什么 Attention 公式里一定要除以 ,除以 行不行?不除行不行?” 我们给出严谨的数学推导与物理第一性原理:- 方差推导(Variance Derivation):
假设向量 和 的每个分量 都是均值为 0、方差为 1 的独立同分布随机变量:
在现代大模型中,单头维度通常为 。如果不除以 ,点积数值的标准差就会放大到 11 以上,导致打分矩阵中出现极大的正数(如 )和极小的负数(如 );
当输入极大时,Softmax 函数输出会被极端推向 one-hot 饱和区(最大值趋近于 1.0,其余全部趋近于 0.0);
而在饱和区,Softmax 的导数 !反向传播梯度瞬间衰减归零(Gradient Vanishing),模型参数彻底停止学习! 3. 结论:除以 将点积分布重新缩放回均值为 0、方差为 1 的平稳区间,确保 Softmax 处于对输入变化最敏感、梯度流动最健康的线性激活带。
2.5 为什么复杂度是 ?长上下文之痛与 FlashAttention 诞生的物理必然
从矩阵计算维度可以清晰推导出标准 Self-Attention 的算力与显存瓶颈:- 计算复杂度: ,因为生成 个分数,每个分数需要 次乘加;
- 显存存储复杂度: ,因为在标准 PyTorch 实现中,必须在 GPU 显存(HBM)中显式分配大小为 的临时中间张量,用于保存 Softmax 前后的打分权重。
💥 长文本下的显存海啸手算:
当序列长度 从 2K 扩展到 128K(增长 64 倍)时: 对于一个 32 头、Batch Size=1 的模型,仅仅单层存储一个 FP16 注意力矩阵需要的显存为:🌟 FlashAttention 的第一性原理破局:
标准 Attention 之所以爆显存,是因为它频繁地将 的巨大矩阵在慢速 HBM(显存)与快速片上 SRAM(共享内存)之间来回搬运读写。
FlashAttention(Tri Dao et al.) 采用了 Tiling(分块分片) 算法与 Online Softmax(在线动态归一化) 技术,在片上 SRAM 内直接完成小分块的 Softmax 累加与 Value 乘法,完全不需要在 HBM 中物化存储 的全局矩阵,将 HBM 访存 IO 从 骤降为 ,既拯救了显存,又大幅消除了访存延迟!
2.6 Multi-Head Attention (MHA):为什么要多头?张量并行(TP)列切与行切拆解
如果只用单头 Attention,模型只能从一种单一的加权视角去观察上下文。Multi-Head Attention(MHA) 将隐藏维度 均分为 个独立的头,每个头的维度为 : 其中 。
🛠️ 大厂张量并行(Megatron-LM Tensor Parallelism)核心拆解:
Multi-Head Attention 与 GPU 分布式张量并行天然契合:- 列并行切分(Column Parallel GEMM):
将 按照注意力头数沿**列方向(Column)**切分到 张 GPU 上(每张卡分得 个头),各卡独立计算局部的 及局部 Attention 输出; - 行并行切分(Row Parallel GEMM):
将输出投影矩阵 沿**行方向(Row)**切分,各卡用局部的 Attention 输出乘以局部的 ; - 通信汇总(AllReduce):
根据矩阵乘法分配律: ,最后只需在多卡之间执行一次极快的集合通信AllReduce(Sum),即可完美还原全量输出,通信开销达到理论最小!
2.7 注意力架构大演进:MHA MQA GQA 的显存优化直觉
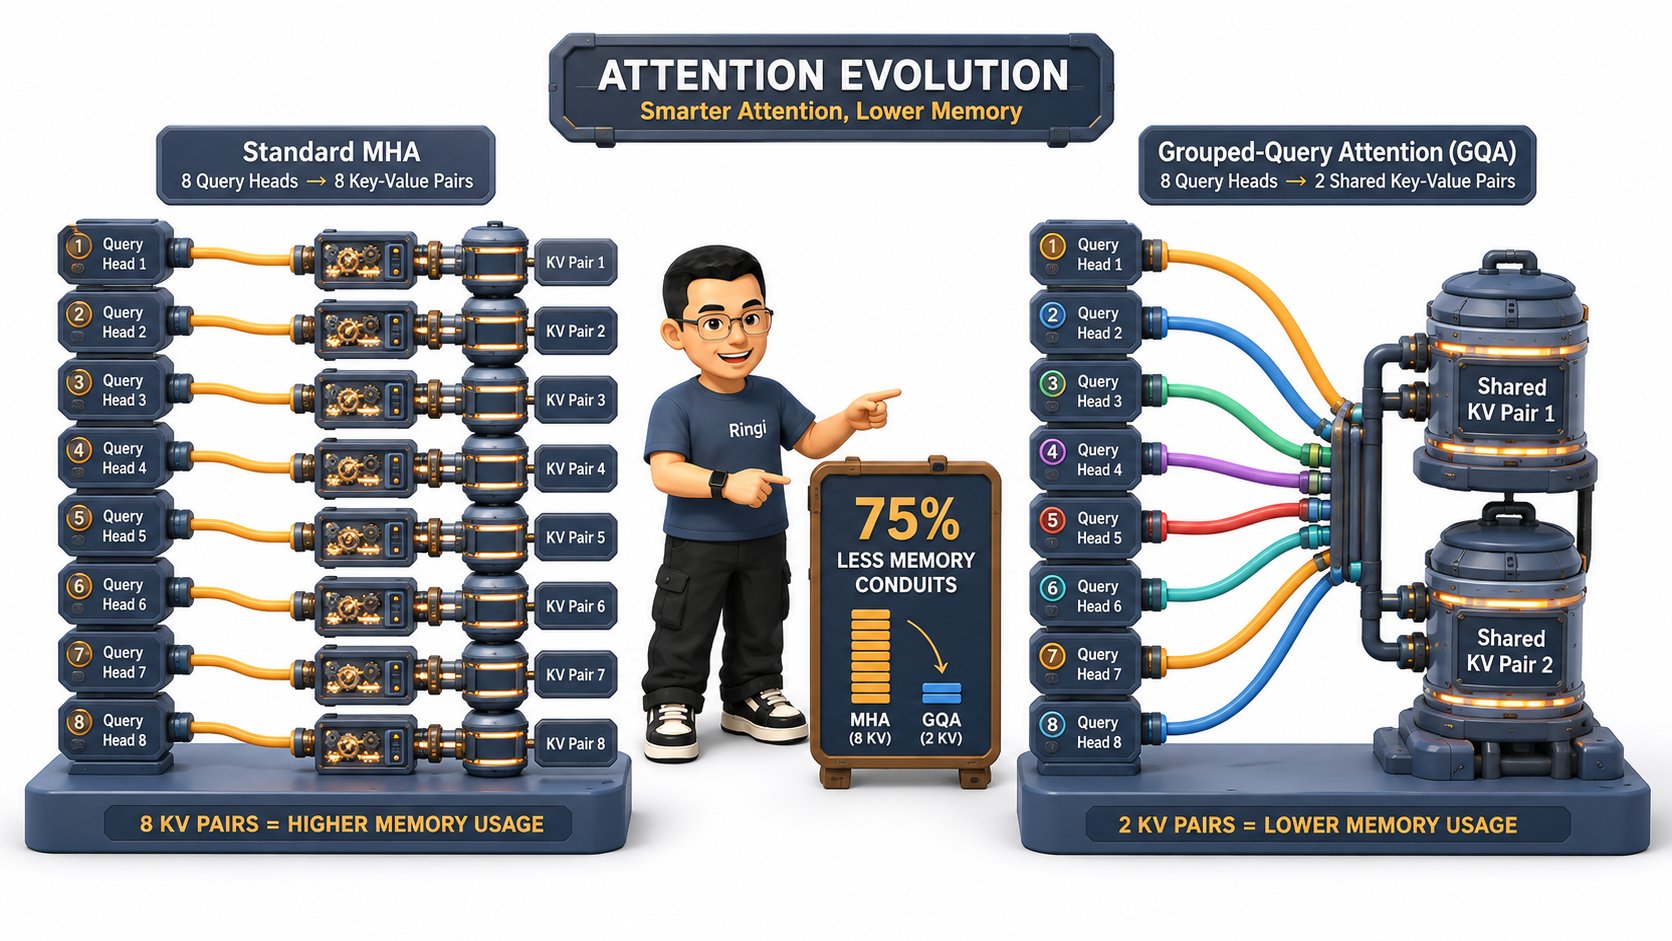
为了在 LLM 推理阶段大幅削减 KV Cache 占用的显存,业界经历了一场壮丽的三代架构演化:- MHA (Multi-Head Attention): 头数完全相同(如 32 个 头对应 32 对 )。表达能力最强,但推理时 KV Cache 显存开销巨大;
- MQA (Multi-Query Attention, Shazeer 2019):所有 头强行共享同 1 对 。KV Cache 显存暴降至 (降至 1/32),但由于强制压缩了键值特征空间,复杂任务下的模型表达精度略有下滑;
- GQA (Grouped-Query Attention, Ainslie 2023):完美的折中方案! 将 头分为 个组(如 32 个 头分为 8 组,每组 4 个 头共享 1 对 )。KV Cache 显存直接削减 75%~87.5%,且模型推理能力几乎与 MHA 100% 持平,已成为 LLaMA-2-70B、LLaMA-3、Mistral、Qwen 等现代开源大模型的绝对统一标配!
3. 前馈网络(FFN)——大模型的深度特征加工厂
3.1 角色分工:Attention 负责横向开会,FFN 负责纵向独立消化
如果说 Attention 机制是全班同学坐在一起开圆桌研讨会(Token 之间跨位置横向交互信息),那么 FFN(Feed-Forward Network)就是研讨会结束后,每个人回到自己的独立工位上闭门消化吸收、提取深层概念记忆的加工厂。- Attention:发生 Token 与 Token 之间的空间特征融合(跨序列维度);
- FFN:对 每个 Token 的特征向量做独立的逐点非线性高阶映射(Point-wise),各个位置的 Token 之间完全独立、互不干扰。
3.2 升维与降维的几何本质:为什么中间维度要扩大到 或 ?
标准 FFN 由两层全连接组成: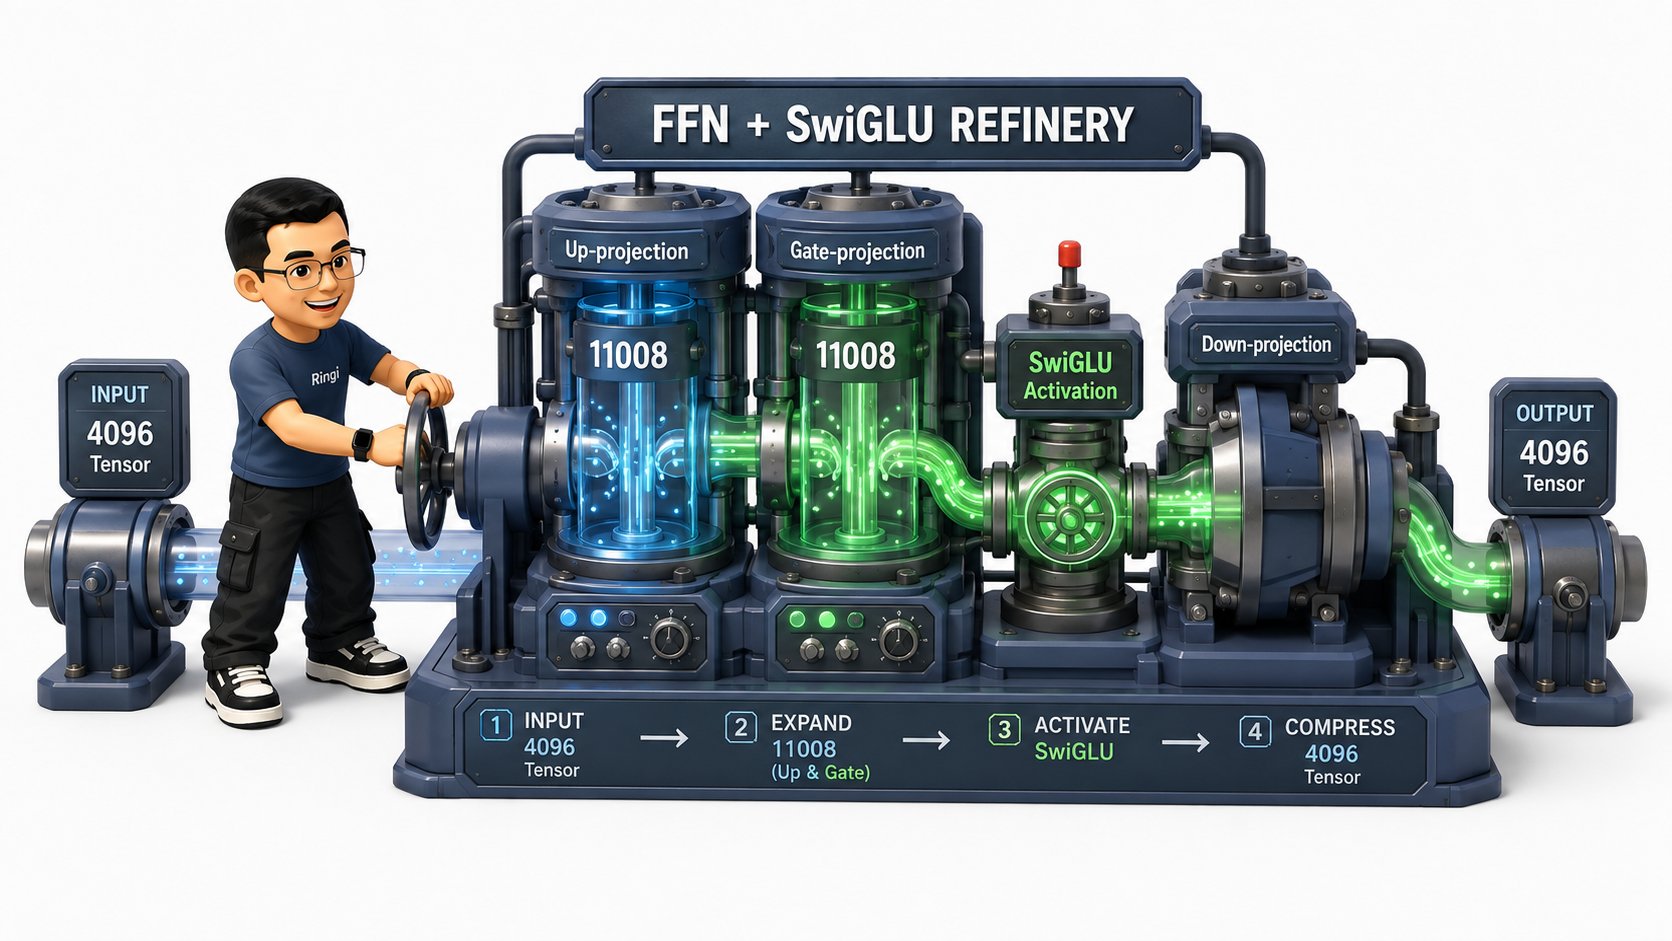
💡 Ringi 几何空间直觉:为什么非要先升维再降维?
设想你在低维平面(如 2D)上有许多相互交织缠绕、无法用直线切分的数据点。当你把这些数据通过升维矩阵投射到高维空间(如 4D 或 8D)后,原本在低维粘连在一起的语义概念就能在一个更广阔的几何自由度里被非线性超平面轻松剥离解耦;经过激活函数提取有效特征后,再通过降维矩阵压缩回原始维度。
3.3 参数量账本手算:为什么 FFN 占了全模型整整 2/3 的参数?
我们以隐藏维度 为例,白板手算单层 Transformer Block 的参数分布:- Attention 模块参数量:
- 包含 四个方阵,每个尺寸为 ;
- 参数量 (占单层约 33%);
- SwiGLU FFN 模块参数量:
- 采用现代 SwiGLU 结构,中间隐藏维度通常设置为 ;
- 包含 三个矩阵:
- FFN 参数量总计 (占单层整整 67%!);
- 结论:在大语言模型中,整整三分之二(67%)的知识与参数量都储存在 FFN 模块中! 这也是为什么 MoE(混合专家模型)优化专门针对 FFN 进行专家切分。
3.4 激活函数三代演进:ReLU GELU SwiGLU 门控机制深度剖析
- 第一代:ReLU
- 第一性原理优势:引入了 双通道门控(Gating) 机制。 负责生成纯粹的特征内容,而 负责动态学习一个 的门控系数,精准控制每个通道信息的通过率,非线性表达能力出现质的飞跃!
4. 位置编码(Position Encoding)——赋予序列时空坐标
4.1 为什么 Transformer 天生是个“词序脸盲”?排列等变性与绝对位置缺失
回顾 Self-Attention 的核心计算: 。如果我们把输入句子
张三 借了 李四 一百块 彻底打乱成 李四 借了 张三 一百块:
- 因为矩阵乘法是逐行逐列的点积,打乱输入行顺序,输出的注意力分数矩阵仅仅是对应地交换了行和列;
- 数学上称之为 排列等变性(Permutation Equivariance)。
- 如果不人为注入位置信息,Transformer 根本无法区分谁是借钱的人,谁是被借钱的人!
4.2 经典绝对位置编码:Sinusoidal 正余弦函数的时钟刻度模型与局限
2017 年原始 Transformer 使用正余弦固定绝对位置编码(Sinusoidal Position Encoding):- 时钟直觉:低维分量变化极快(对应“秒针”),高维分量变化极慢(对应“时针”),组合起来构成每个位置唯一的二进制式时空指纹;
- 致命缺陷:直接将 加到输入 Embedding 上,随着网络层数加深,位置信号会被后续的矩阵乘法严重稀释冲淡,且在处理超出训练长度的外推(Extrapolation)时表现极其糟糕。
4.3 现代大模型霸主:RoPE(旋转位置编码)的 2D 复数几何魔术
由苏剑林等提出的 RoPE(Rotary Position Embedding),是当今全世界所有主流开源与商业大模型(LLaMA-1/2/3, Mistral, Qwen, DeepSeek 等)的唯一绝对统一标准。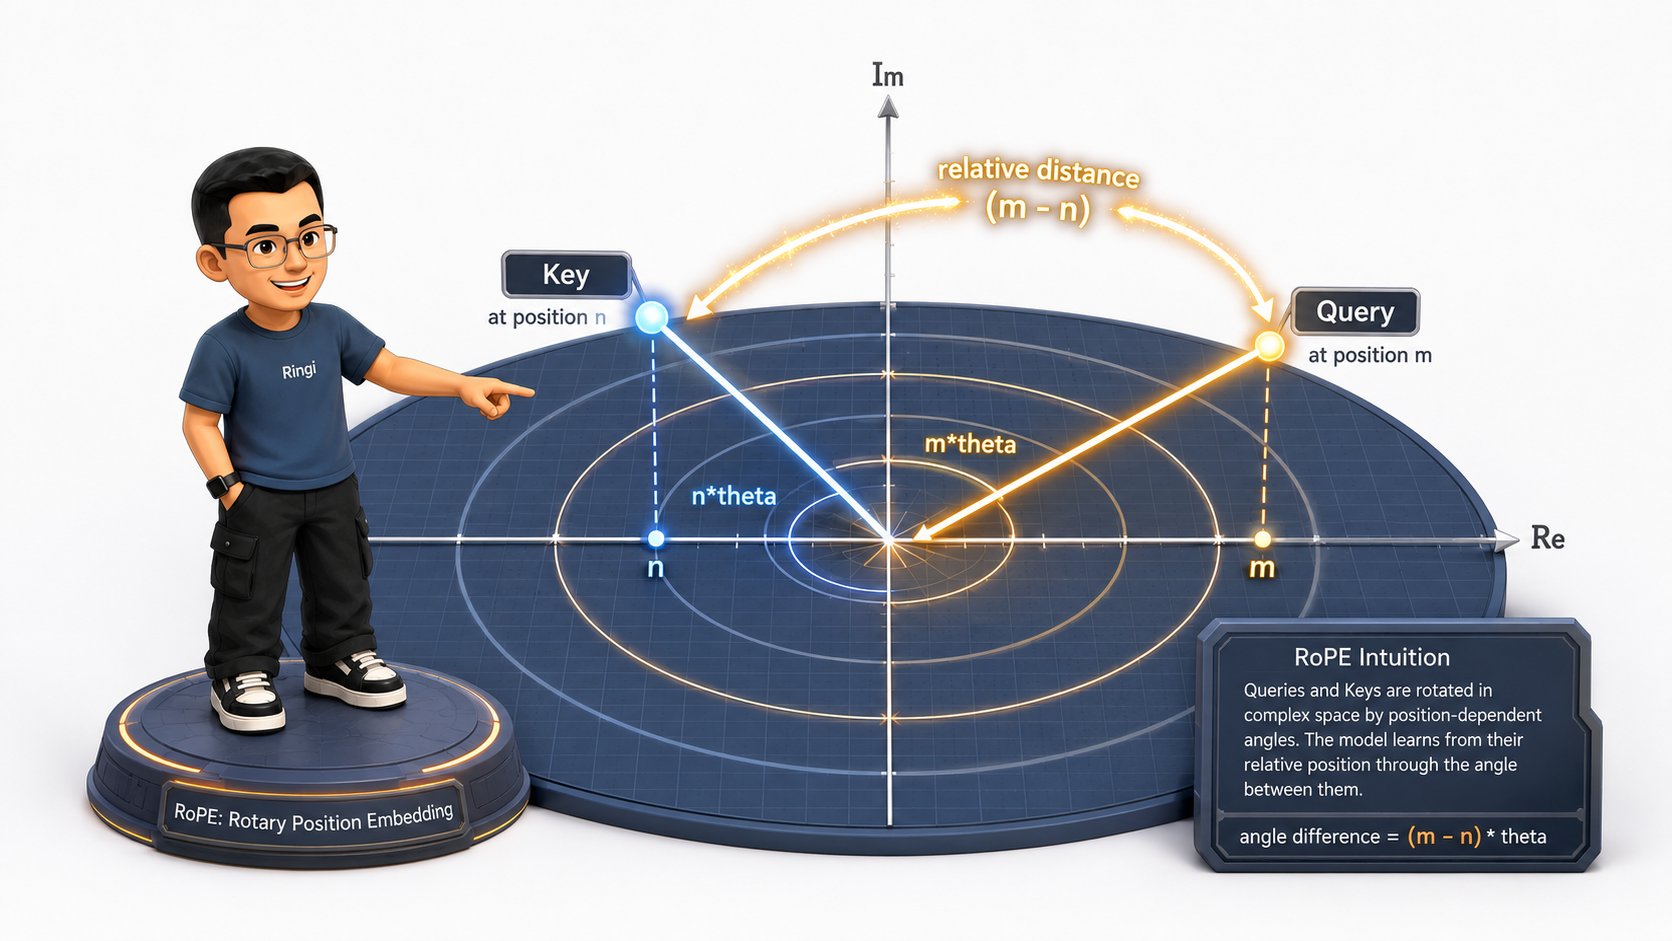
4.3.1 2D 平面旋转矩阵推导
RoPE 不在 Embedding 处做任何加法,而是在每个 Attention Head 计算 点积前,将向量每相邻两个维度作为一个 2D 平面坐标,按照其所处的 Token 绝对位置角度进行逆时针旋转! 设二维向量 ,在位置 处的旋转角度为 ,旋转矩阵为: 旋转后的 Query 向量为:4.3.2 复数内积:为什么绝对位置旋转能自然涌现相对距离 ?
这是 RoPE 最惊艳的数学之美!将 2D 向量视为复数: 。在位置 旋转后变为: ;同样在位置 处的 Key 旋转后变为: 。 当它们计算注意力打分点积时(对应复数共轭内积 ): 看到了吗?!绝对位置坐标 和 在相乘的瞬间彻底消失了,留下的相位角严格等于两者的相对距离 !
📌 Ringi 工程师三问闭环:
- 为什么语义更好:自然语言中,“词 A 与词 B 距离为 2”的相对语法关系,远比“词 A 位于整本书第 5328 位”的绝对坐标重要千百倍;
- 长文本外推拓展:在做长上下文拓展(如从 4K 扩到 128K)时,只需对基频 做位置插值(PI)或 YaRN 缩放,即可无损拓展!
4.3.3 RoPE 的 CUDA Kernel 实现:纯逐元素旋转与零额外显存分配
在 GPU 底层工程实现中,RoPE 不需要像传统位置编码那样开辟巨大的权重矩阵:- 它是一个纯粹的 逐元素变换(Element-wise Operation);
- 在 PyTorch / Triton 中,通常将 RoPE 与前面的 QKV GEMM 或后面的 FlashAttention 直接做 Kernel Fusion(算子融合),向量在片上寄存器内部顺手旋转完毕,不产生任何 HBM 读写和显存分配!
5. 归一化与残差连接——深层网络的定海神针
5.1 残差连接(Residual Connection):梯度无损直通的高速公路
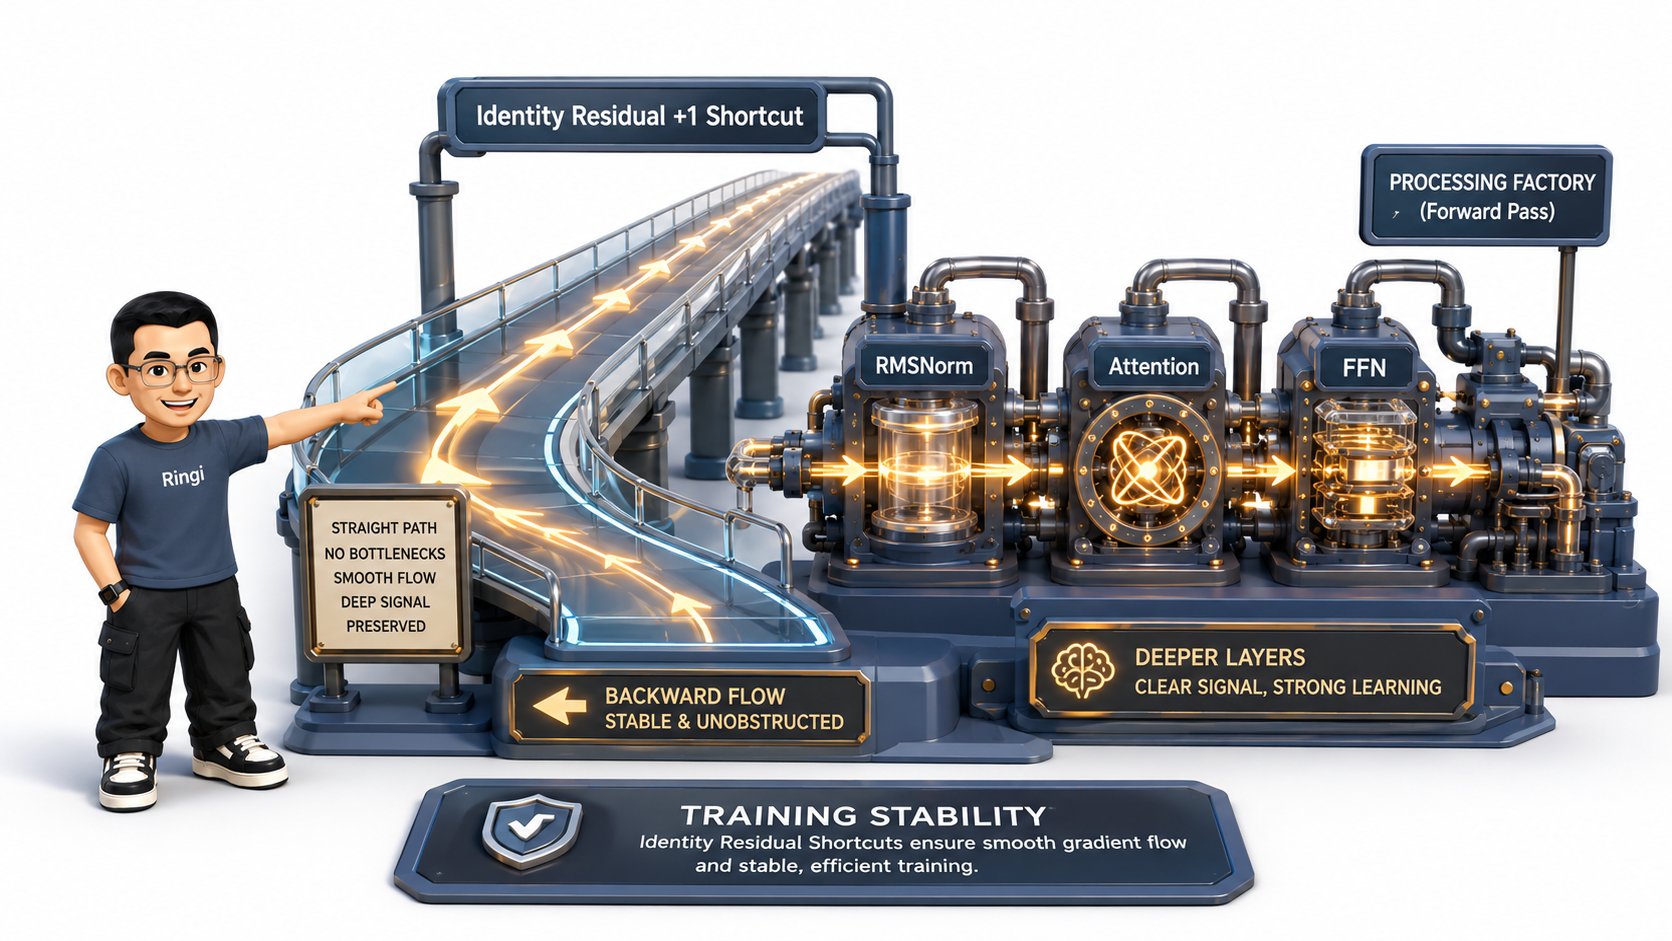
为什么大模型能堆叠 100 层而不退化?
对残差公式求反向传播导数: 注意那个恒等项 !无论子层网络 的权重矩阵被训练得多小、导数多么接近 0,梯度都可以沿着主干道无损、不衰减地一直回传至最底层的 Embedding 层,从根本上消除了深层网络的梯度弥散(Vanishing Gradient)。5.2 LayerNorm vs RMSNorm:均方根归一化如何省去内存扫描提速 7%?
- 传统 LayerNorm(带均值与方差):
Zhang & Sennrich (2019) 证明,LayerNorm 的成功核心在于尺度缩放不变性,均值平移( )几乎没有贡献。
RMSNorm 直接舍弃均值计算:
- 硬件性能收益:少了一遍全局 Reduce 规约求和与均值相减,减少了片上寄存器开销与 HBM 访存,单算子执行速度在 GPU 上提升 约 7%~15%!
5.3 Pre-Norm vs Post-Norm:数十亿美元训练稳定性之争
6. 完整的 Transformer Decoder Block 组装与全流程张量 Shape 流动表
现在,我们把所有的齿轮拼装成一块完整的工业级标准积木:6.1 Pre-Norm Decoder Block 结构全景图与因果数据流
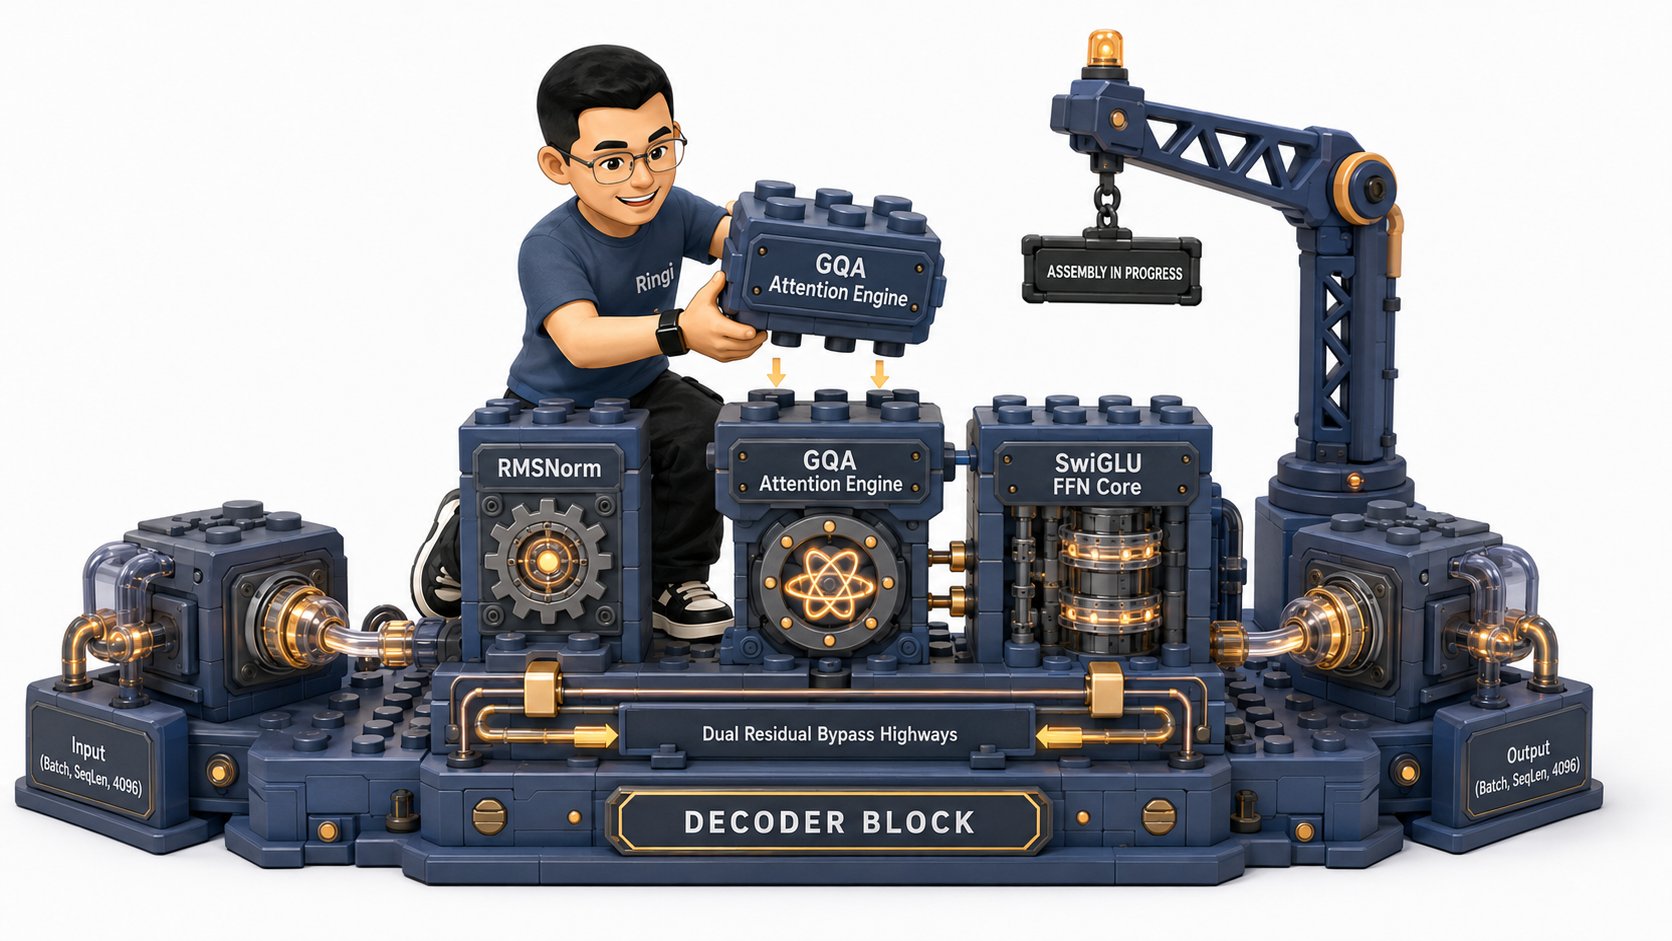
6.2 LLaMA-2-7B 全流程张量维度逐算子追踪表(Shape, Strides, Contiguous)
设批大小 ,序列长度 ,模型隐藏维度 ,头数 ,单头维度 ,FFN 中间维度 :🌟 极客观察:进入单个 Block 前的 Shape 是(2, 2048, 4096),从 Block 出来的 Shape 依旧严格为(2, 2048, 4096)!这种完美的对称性使得 32 层乃至 80 层 Block 可以像搭积木一样无限串联。
6.3 白板手算:LLaMA-2-7B 单层 202M 参数与全模型 6.74B 参数精确手算推导
我们手把手推导 LLaMA-2-7B(32 层,隐藏维度 4096,词表大小 32000)的全部参数:1. 单个 Decoder Block 参数量精确手算:
- Attention 投影矩阵:
- FFN SwiGLU 矩阵:
- 2 个 RMSNorm 缩放系数:
- 单层 Block 参数总计:
2. 全模型总参数量精确手算:
- 32 层 Decoder Blocks:
- Token Embedding 查找表:
- Final RMSNorm:
- LM Head 输出头(不共享权重时):
- 全模型理论参数精确总和:
6.4 静态与动态显存四账本精确推导(Weights, Gradients, AdamW 16B/param, Activations)
在 AI Infra 领域,显存四账本是预测集群 OOM 边界的最高准则:- 静态模型权重(Weights, FP16/BF16):每个参数占 2 字节
- 反向传播梯度(Gradients, FP16/BF16):每个参数占 2 字节
- AdamW 优化器状态(Optimizer States):每个参数需要 16 字节
- FP32 Master Weights 副本(4 字节)
- FP32 一阶动量 Momentum(4 字节)
- FP32 二阶动量 Variance(4 字节)
- 额外的临时梯度转换缓冲(4 字节)
- 训练静态显存基线:
💡 7B 模型的静态训练显存基线高达 134.8GB,远超单张 A100(80GB)容量!必须通过 ZeRO-1/2/3 显存切分 将 107.8GB 优化器状态均匀打散到 8 张 GPU 上(单卡优化器显存降为 ),才能在单机 8 卡上稳健训练。
7. 从 Transformer 到 LLM 推理:自回归生成与 KV Cache 革命
7.1 自回归生成(Autoregressive)机制与两阶段划分
大语言模型的文本生成过程,是一个循环往复的自回归预测流:7.2 Prefill(Compute-Bound)vs Decode(Memory-Bound)的物理瓶颈与 Roofline 定位
LLM 在线推理具有截然相反的两个物理阶段: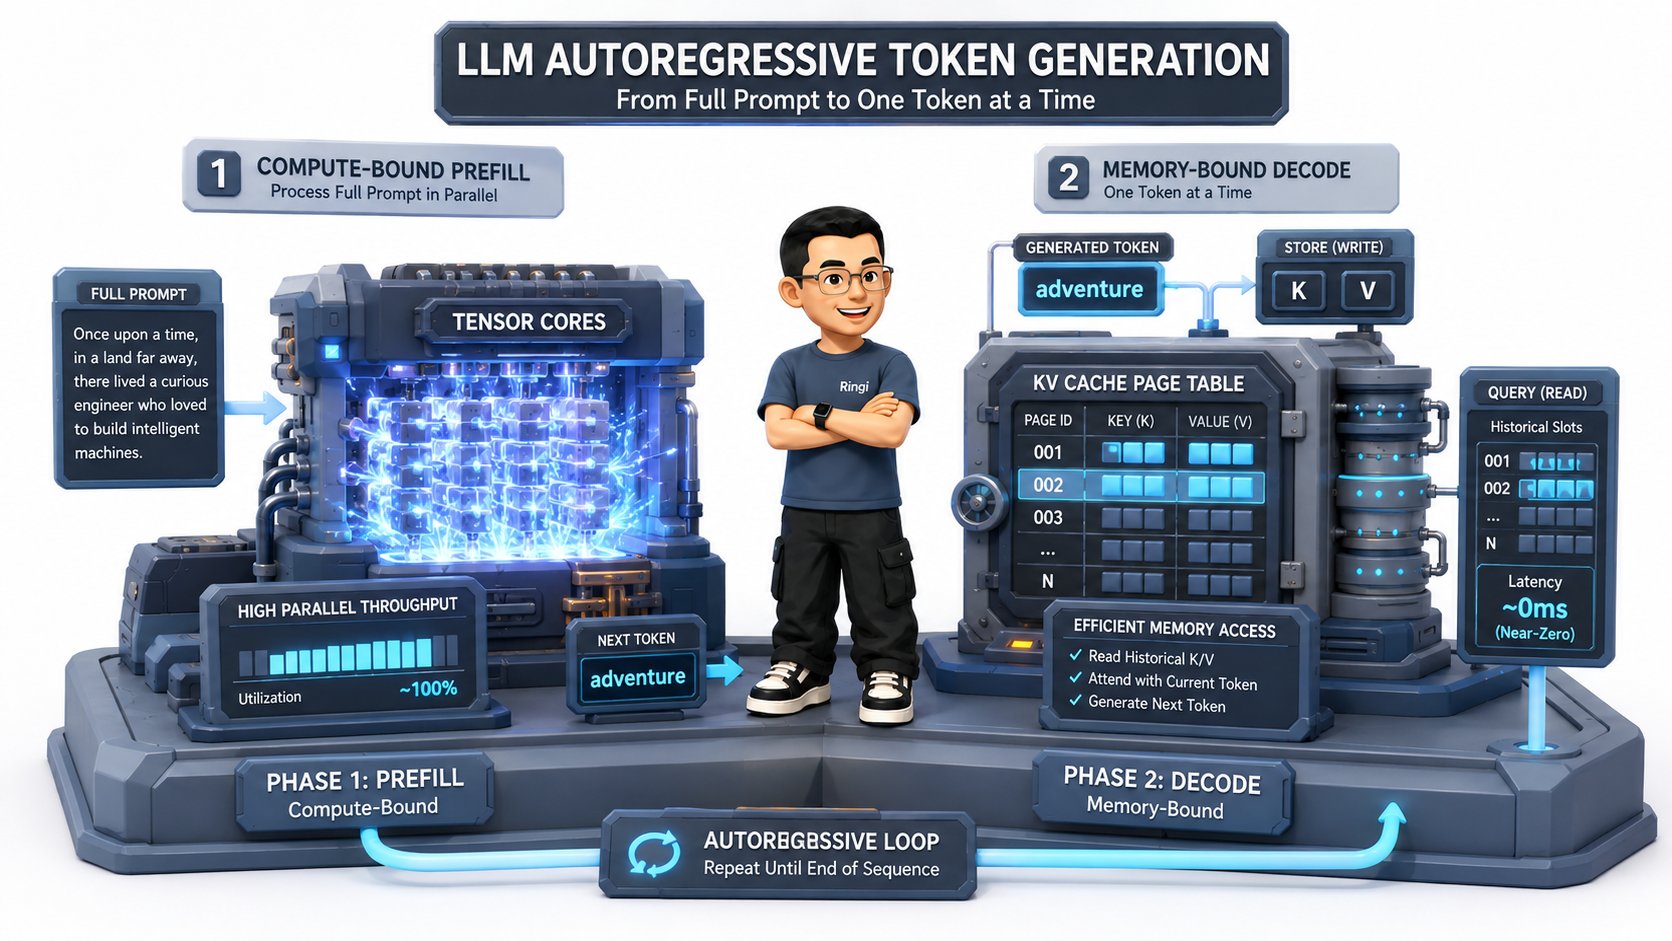
7.3 KV Cache 第一性原理:计算复杂度从 骤降至
在自回归 Decode 阶段,生成第 个 Token 时,其 必须和前 个历史 Token 的 做注意力打分,再加权聚合 。- 不开启 KV Cache 的荒谬做法:每生成 1 个新词,都要把前面所有的词从头到尾重新跑一遍前向投影计算 !生成 个词的总计算量为 ,算力被极其严重地浪费;
- 开启 KV Cache 的第一性原理:历史 Token 经过线性投影得到的 和 在后续的生成中数值永远不会改变!因此,我们在 Prefill 阶段将历史所有层、所有头的 张量常驻缓存在显存中;Decode 每一步只需要计算当前 1 个 Token 的 ,把新的 写入缓存尾部即可,单步计算复杂度降为 !
7.4 KV Cache 显存开销公式手算(单 Token 512KB 4K 上下文 2GB 并发显存海啸)
1. 单个 Token 的 KV Cache 显存公式手算:
对于 LLaMA-2-7B(32 层,32 头,单头 128 维,FP16 占 2 字节): 代入参数:2. 长上下文与高并发下的显存海啸:
- 单个长对话请求(序列长 4096 Token):
- 当线上并发请求达到 Batch Size = 32 时:
7.5 vLLM PagedAttention 虚拟内存分页管理机制(物理 Block、Page Table 与碎片消除)
传统的 Serving 框架(如早期的 HuggingFace Accelerate)要求为每个请求预分配一段连续的物理显存作为 KV Cache。这导致了三大致命缺陷:- 内部碎片(Internal Fragmentation):为了防止 OOM,系统必须按照最大长度(如 4096)预分配,但用户往往只聊了 200 个字,超过 90% 的显存被白白浪费;
- 外部碎片(External Fragmentation):不同请求长度不一,内存频繁申请释放产生大量细小碎片,实际利用率不足 40%;
- 无法共享前缀(No Prefix Sharing):多轮对话中的 System Prompt 在每个请求中都被重复存储多份。
🌟 PagedAttention 的操作系统级革命:
UC Berkeley 团队提出的 vLLM (PagedAttention) 借鉴了操作系统的虚拟内存分页思想:
- 将物理显存切分成固定大小的小块(如每个 Block 存放 16 个 Token 的 KV);
- 显存无需在物理上连续,而是通过一张 Page Table(页表) 将逻辑上的连续 Token 动态映射到离散的物理 Block 中;
- 请求需要生成新 Token 时,动态向全局空闲池申请一个新 Block;
- 彻底消除了内存碎片,将显存利用率从不足 40% 提升至 96% 以上,Serving 系统的并发吞吐量直接暴涨 2~4 倍!
8. 动手实战与代码实验室(Minimal Runnable Code)
下面我们通过 4 个最小可运行、手撕核心算子与系统机制的高性能代码实验,亲眼验证本讲的全部理论!8.1 实验 1:纯 PyTorch 手写一个支持 RoPE、SwiGLU 与 GQA 的标准 Decoder Block
8.2 实验 2:MHA vs MQA vs GQA KV Cache 显存占用与吞吐对比测试
8.3 实验 3:自回归生成中开启 KV Cache 前后端到端耗时与算力利用率压测
8.4 实验 4:简易版 PagedAttention 显存物理 Block 分配与逻辑 Page Table 映射模拟器
9. Ringi 避坑指南与大厂硬核经典面试题
9.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
9.2 4 道大厂高频硬核面试与白板推导题(含详细推导过程、解题思考路径与标准答案)
💡 题目一:白板推导 RoPE 旋转位置编码的复数相对位置内积不变性
面试官追问:请手写 2D 平面旋转矩阵,并用复数形式推导出为什么两个绝对位置 与 处的向量旋转后做内积,其结果只与相对距离 有关?
🎯 答题思考路径与标准推导:
- 构造 2D 平面旋转矩阵:
设二维实数向量 。将其视作复数: ;
在位置 处,旋转矩阵 对应复数乘法算子 。旋转后的向量为:
- 同理构造 Key 向量:
设 ,在位置 处旋转后为:
- 计算实数点积与复数内积的恒等关系:
两个 2D 实向量的点积,严格等于其对应复数与其共轭复数相乘的实部:
- 结论:点积结果中绝对位置 和 全部抵消,仅剩下相对位置差 ,完美证明了相对位置编码的自然涌现!
💡 题目二:手算 70B GQA 模型(如 LLaMA-2-70B)单 Token KV Cache 大小与并发显存需求
面试官追问:已知 LLaMA-2-70B 配置为:80 层( ),隐藏维度 ,Query 头数 64,采用 GQA(8 对 KV 头, ),单头维度 128,采用 FP16 存储。请手算:
- 单个 Token 的 KV Cache 显存大小;
- 当序列长度为 4096,并发 Batch Size = 64 时,整套集群需要多少 GB 的显存专门存放 KV Cache?
🎯 答题思考路径与标准答案:
- 单 Token 显存手算:
- 总并发显存手算:
- 单个请求(4096 Token)的 KV Cache 大小:
- 64 并发请求的总 KV Cache 显存:
- 架构对比与分析:
如果该模型采用原始 MHA(64 对 KV 头),单 Token 显存将高达 ,64 并发总显存将达到惊人的 (整整 8 张 A100 全被撑爆)!GQA 将 KV Cache 显存直接压缩了 87.5%,使得单机 8 卡能够轻松承载高并发长文本服务。
💡 题目三:深度对比 Attention 与 FFN 在张量并行(Tensor Parallelism)中的切分差异
面试官追问:在 Megatron-LM 的单机多卡张量并行(TP)中,Self-Attention 模块与 FFN 模块分别是如何进行列并行与行并行切分的?为什么整个 Block 只需 2 次 AllReduce 通信?
🎯 答题思考路径与标准答案:
- Self-Attention 切分流水线:
- Column Parallelism(列切): 沿输出通道切分,每张 GPU 独立持有 的注意力头,直接在本地算完局部点积与 Value 聚合,中间零通信;
- Row Parallelism(行切):输出投影矩阵 沿输入通道切分,每张卡用局部注意力输出乘以局部的 ;在离开 Attention 模块前,执行 第 1 次
AllReduce(Sum)将多卡局部结果累加求和并与残差相加;
- FFN 模块切分流水线:
- Column Parallelism(列切):升维矩阵 与 沿输出通道(中间维度 )切分,各卡在本地独立完成 GEMM 并在片上完成 SwiGLU 逐元素门控激活,中间零通信;
- Row Parallelism(行切):降维矩阵 沿输入通道切分,各卡乘以局部激活值;在离开 FFN 模块前,执行 第 2 次
AllReduce(Sum)累加多卡输出并与残差相加;
- 通信开销极致精简:
每个 Decoder Block 包含 2 次大矩阵乘法组合,通过“列切 激活 行切 AllReduce”的巧妙镜像对称设计,将跨卡集合通信严格压制在每层仅有 2 次 AllReduce,最大化利用了 NVLink 的高带宽。
💡 题目四:为什么大模型 Decode 阶段是 Memory-Bound(带宽受限)?请用 Roofline 模型与算术强度(Arithmetic Intensity)证明
面试官追问:请手算单 Token Decode 时的浮点计算量(FLOPs)与最小显存读取量(Bytes),推导出其算术强度,并在 NVIDIA A100(312 TFLOPS BF16, 2.0 TB/s HBM 带宽)的 Roofline 模型下进行瓶颈归因。
🎯 答题思考路径与标准答案:
- 单 Token 生成时的计算与访存建模:
设模型参数量为 (以 70B 模型为例,采用 FP16/BF16,每个参数 2 字节):- FLOPs 计算量:每个 Token 经过模型前向的所有矩阵乘法,每个参数需要 1 次乘法和 1 次加法,计算量严格为:
- HBM 访存读取量:因为每生成 1 个 Token 都必须将全部 70B 权重从 HBM 读取到片上寄存器一次,读取权重字节数为:
- 算术强度(Arithmetic Intensity)计算:
- Roofline 模型硬件拐点对比:
- NVIDIA A100-SXM4-80GB 的硬件拐点为:
- 归因结论:
Decode 阶段的实际算术强度( )远小于硬件拐点( )整整两个数量级!
系统处于极端的 Memory-Bound(带宽受限) 状态。GPU 强大的 Tensor Core 几乎全程处于饥饿空转,每秒能够生成的 Token 上限完全被 HBM 显存读取带宽死死卡住!
10. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
10.1 5 点押韵核心速记口诀
10.2 10 条白板自我检验清单
- Q1:能否在白板上默写出 Pre-Norm Decoder Block 的完整计算流,并准确标出 RMSNorm 与残差连接的位置?
- Q2:能用自己的话说清 三个矩阵的物理含义,以及 Attention 打分点积的几何直觉吗?
- Q3:为什么在 Attention 点积后必须除以 ?请给出均值为 0、方差为 1 的数学推导。
- Q4:请推导 Self-Attention 的 显存复杂度,并说明 FlashAttention 是如何利用片上 SRAM 消灭 显存 IO 的?
- Q5:为什么 Multi-Head Attention 天然适合做 Megatron-LM 张量并行(TP)切分?说明列并行与行并行的配对规则。
- Q6:请画出 MHA MQA GQA 的演进示意图,并说明 GQA 为什么能节省 75% 以上的 KV Cache 显存?
- Q7:为什么 FFN 模块占了全模型 67% 的参数量?SwiGLU 的门控通道起到了什么物理作用?
- Q8:请在白板上手撕 RoPE 旋转位置编码的复数内积不变性证明。
- Q9:请手算 LLaMA-2-7B 的单层 Block 参数(202M)与全模型参数(6.74B)。
- Q10:为什么大模型 Decode 阶段是 Memory-Bound?单 Token 算术强度是多少?vLLM PagedAttention 如何解决显存碎片?
10.3 3 道高阶开放式课后思考题(含极限 Corner Case)
- 分布式显存倾斜思考题:在采用流水线并行(Pipeline Parallelism)训练 70B 模型时,第 1 个 Stage(持有网络最前部 Block)和最后 1 个 Stage(持有 Embedding 与 LM Head)通常显存占用不均。结合本讲的参数与激活显存账本,分析为什么最后 1 个 Stage 往往显存压力最大?工业界是如何通过 Tie-Weight(权重共享)或切分 LM Head 来平衡显存的?
- 长文本外推极限挑战题:当把一个预训练长度为 4096 的 LLaMA-3 模型,通过修改 RoPE 基频 直接扩展到 128K 上下文时,注意力矩阵 会发生什么数值退化?为什么简单的线性内插(Linear Interpolation)会导致困惑度(PPL)爆炸?YaRN 与 Dynamic NTK-aware 缩放的底层物理机制是什么?
- PD 解耦架构前沿探索题:鉴于 Prefill 阶段是 Compute-Bound(算力受限),而 Decode 阶段是 Memory-Bound(带宽受限),业界最新的 PD 分离架构(Prefill-Decode Disaggregation, 如 Mooncake / Splitwise) 将两类节点在物理集群上彻底解耦。请分析:在将 Prefill 节点生成的数百 MB KV Cache 跨机传输给 Decode 节点时,RDMA 网络带宽会成为新的瓶颈吗?如何通过传输与计算重叠(Overlap)来隐藏网络延迟?
11. 📚 参考资料与经典开源实现源码指引
- 经典开山与架构奠基论文:
- Vaswani et al. (2017): “Attention Is All You Need”. NeurIPS 2017.(Transformer 开山祖师之作,首创自注意力机制);
- Radford et al. (2019): “Language Models are Unsupervised Multitask Learners”.(GPT-2 确立 Decoder-only 纯自回归架构基准);
- Touvron et al. (2023): “LLaMA: Open and Efficient Foundation Language Models”. arXiv:2302.13971.(开源大模型架构标准,全面普及 Pre-RMSNorm、RoPE 与 SwiGLU);
- Su et al. (2024): “RoFormer: Enhanced Transformer with Rotary Position Embedding”. Neurocomputing.(RoPE 旋转位置编码数学原著);
- Shazeer (2020): “GLU Variants Improve Transformer”. arXiv:2002.05202.(SwiGLU 门控激活函数奠基论文);
- Ainslie et al. (2023): “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints”. EMNLP 2023.(GQA 分组注意力原著);
- Dao et al. (2022): “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness”. NeurIPS 2022.(片上 SRAM 算子融合与 IO 感知经典之作);
- Kwon et al. (2023): “Efficient Memory Management for Large Language Model Serving with PagedAttention”. SOSP 2023.(vLLM 虚拟内存分页管理开山力作)。
- 权威工业级开源实现代码仓库(建议克隆精读):
- Meta LLaMA 官方实现:
meta-llama/llama—— 研读最干净、标准的 LLaMA Decoder Block、RoPE 预计算与 GQA 投影源码; - NVIDIA Megatron-LM:
NVIDIA/Megatron-LM—— 深入研读工业级张量并行(TP 列切/行切)与分布式 Transformer 实现; - vLLM PagedAttention 内核:
vllm-project/vllm—— 研读高并发 Serving 引擎中 PagedAttention 的 CUDA / C++ 源码实现。
- Meta LLaMA 官方实现: