🏛️ 项目五:从单算子到端到端——FlashAttention 全景演进与大模型 Token 生成全链路性能优化实战(FA-1/2/3 微架构 · Prefill/Decode 冲突治理 · 连续批处理 · 投机采样 · PD 分离)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 08: Capstone 综合实战项目库
篇章范式:⚙️ 算子内核与端到端系统全链路优化实战篇(Kernel Microarchitecture & End-to-End Inference System Paradigm)
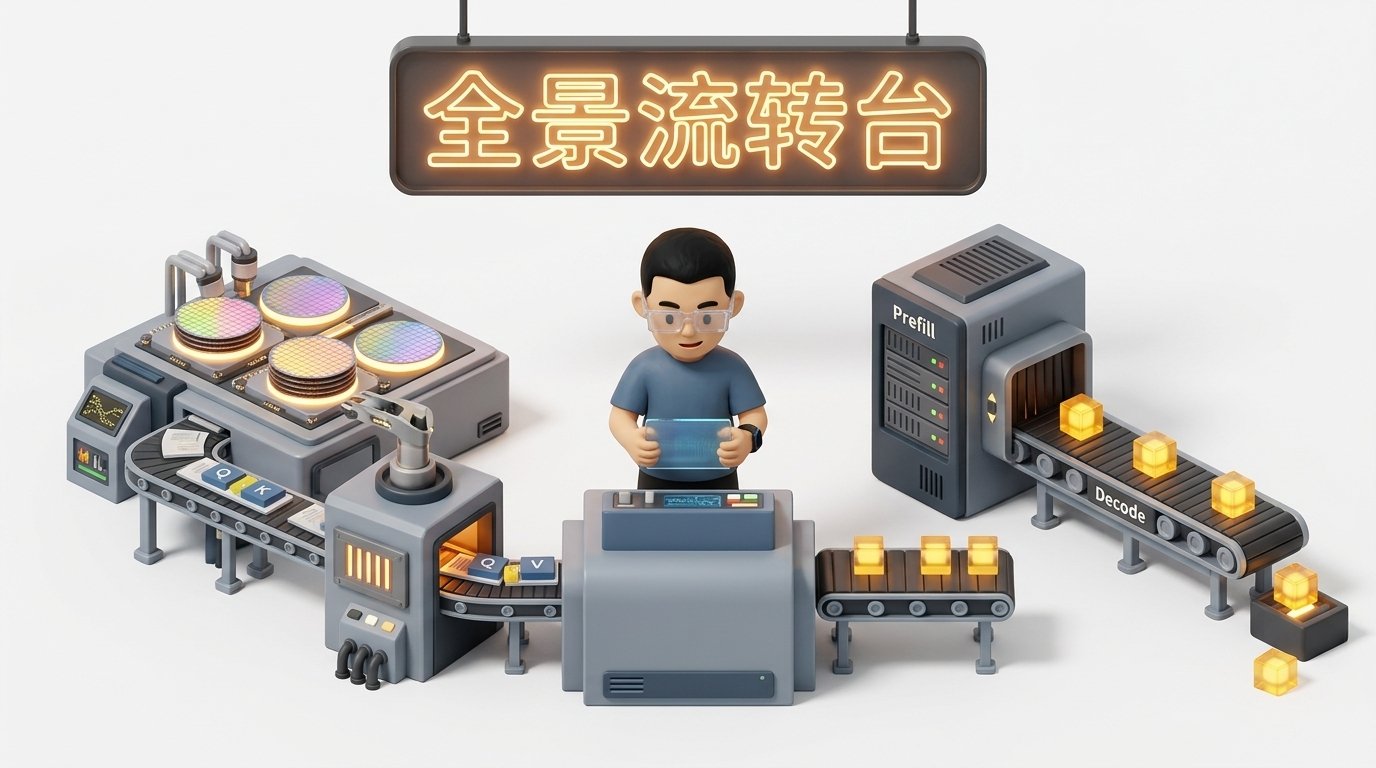
核心导读:一个大模型服务在线上跑得慢,究竟是 Attention 算子写得烂,还是整个系统的 Token 流水线调度被访存墙卡死了?为什么 FlashAttention 在长文本 Prefill 阶段能带来数倍飞跃,但在单个 Token 逐字吐出(Decode)时却无法救活几乎闲置的 Tensor Core?大模型每产生一个 Token,底层芯片究竟经历了怎样的算力与带宽折磨?本文带你从单算子的片上 SRAM 熔炉出发,一路穿透到现代推理引擎的整机吞吐战场。
📑 目录导航
- 0. Ringi 现场复盘:长上下文涌入引发的 P99 暴涨与算力雪崩事故
- 1. 第一部分:算子基石——FlashAttention 第一性原理与微架构演进
- 2. 第二部分:巅峰迭代——FlashAttention-1、2 到 FlashAttention-3 微架构深拆
- 3. 第三部分:宏观全景——大模型 Token 产生的全生命周期与双阶段撕裂
- 4. 第四部分:端到端 Token 生成全链路核心优化矩阵
- 5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
- 6. 第六部分:生产落地避坑指南与黄金准则
- 7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
- 8. 第八部分:知识库与权威论文证据溯源
- 附录:Appendix A — 大厂高频白板推导面试真题深度破局
- 9. 4 张 16:9 纯白底 3D 潮玩工坊插图生图 Prompt
0. Ringi 现场复盘:长上下文涌入引发的 P99 暴涨与算力雪崩事故
在某大厂大模型线上电商客服与知识库搜索(RAG)系统中,模型部署在两台 8x H100 节点上提供高并发服务。日常业务以短问短答(输入 200 Tokens,输出 100 Tokens)为主,系统平均响应时间(P99)稳定在 320ms,系统吞吐维持在每秒 3,500 Tokens,指标一切向好。 然而在早高峰大促期间,运营团队突然接入了长文本 PDF 摘要功能,用户的平均 Prompt 长度陡增到 16,384(16K)Tokens:- 监控指标全面变红:
- 首字延迟(TTFT):从原先的 180ms 飙升至 9.4 秒;
- 逐字生成延迟(TPOT / Time Per Output Token):从原先的 18ms 劣化为 120ms,打字机输出出现明显卡顿;
- 更致命的是:原本正在平稳吐字的短文本请求被瞬间打断挂起,出现长时间的“假死”等待;
- 显存与算力倒挂:GPU 显存占用率高达 98.2%,频频抛出 OOM 异常触发 Pod 重启;但 Nsight Profiler 抓取显示,GPU Tensor Core 的平均利用率却狂跌至不足 12%!
- 微观视角:穿透到单算子物理微架构中,彻底搞懂 FlashAttention(从 FA-1、FA-2 到 FA-3)在片上 SRAM 中究竟施展了什么魔法;
- 宏观系统视角:穿透到大模型从 Prompt 到单个 Token 产出的全生命周期中,看懂 Prefill 与 Decode 两个极端世界的物理冲突,并看清现代推理引擎为了护航每个 Token 诞生所构建的一整套端到端优化防线!
1. 第一部分:算子基石——FlashAttention 第一性原理与微架构演进
1.1 标准 Attention 的访存泥潭与算术强度断崖
在 Transformer 中,自注意力机制的标准数学定义举世皆知: 但如果你把这行公式直接用 PyTorch 裸写并在 GPU 上执行,就会在底层硬件上诱发一场灾难性的显存搬砖泥潭。为什么算它?(The Problem)
现代 NVIDIA GPU(如 A100 / H100)的算力增长远远甩开了显存带宽的增长:- A100 SXM4:FP16 算力高达 312 TFLOPs,而 HBM2e 显存带宽仅为 2,039 GB/s(~2 TB/s);
- H100 SXM5:FP16/BF16 算力高达 989 TFLOPs,而 HBM3 显存带宽为 3.35 TB/s。
标准 Attention 的显存读写账本(Tiny Calculator):
设序列长度为 ,Head 维度为 (以典型值 ,FP16 存储即 2 字节/元素 为例):- 第 1 步: 矩阵乘:
- 算力消耗: FLOPs;
- 显存读写:从慢速 HBM 读入 ( 字节),但必须将巨大的注意力分数矩阵 完整写入 HBM(消耗 字节!)。
- 第 2 步: 归一化:
- 显存读写:从 HBM 重新读入 ( 字节),按行求最大值、求指数和,再将得到的注意力权重矩阵 再次写回 HBM(消耗 字节!)。
- 第 3 步: 矩阵乘:
- 算力消耗: FLOPs;
- 显存读写:从 HBM 重新读入 ( 字节)和 ( 字节),最终计算出 写回 HBM( 字节)。
- 中间矩阵 和 各占 ;
- 仅仅一个 Attention Head,为了算一次前向就要在 HBM 和芯片之间搬运近 800 MB 数据;
- 其算术强度低至:
1.2 No Naked Formula 2.0:Online Softmax 单趟流式递推数学严密证明
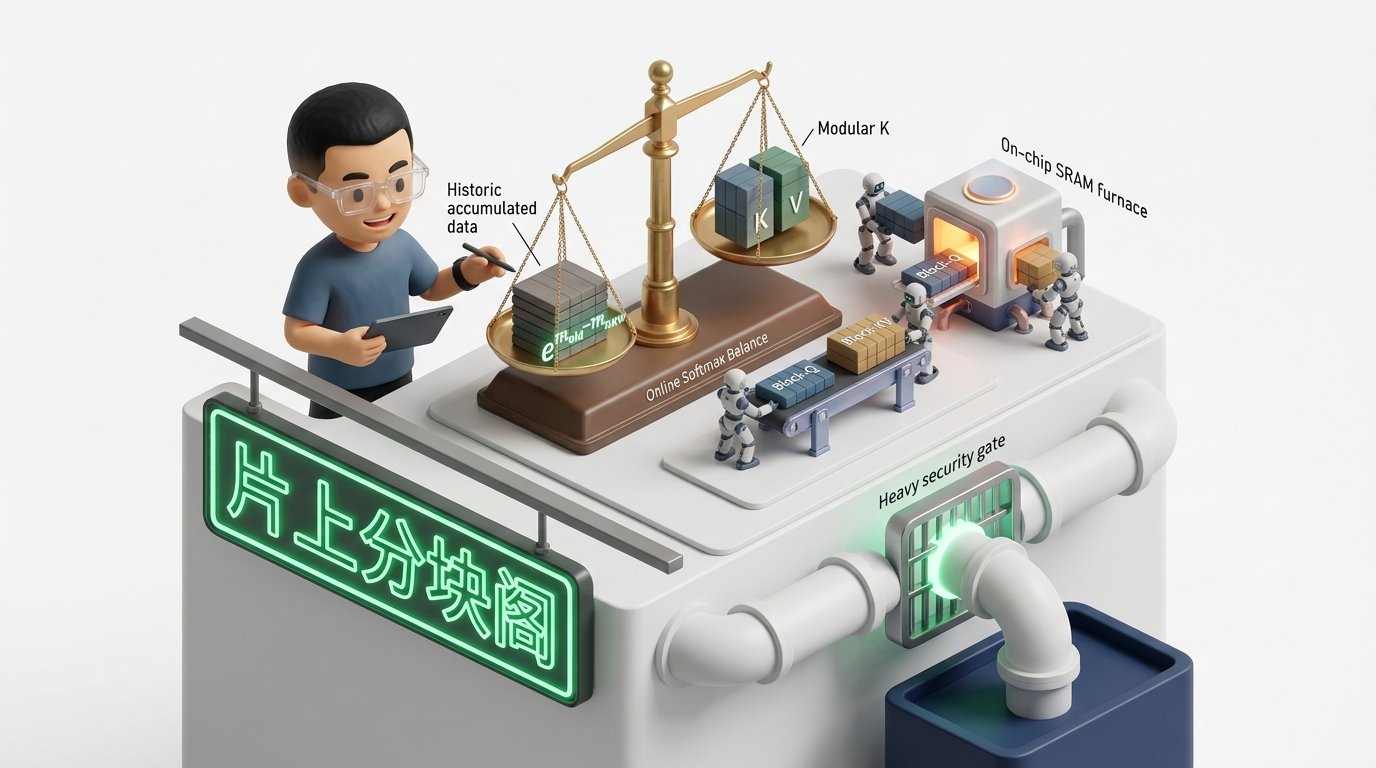
能否根本不把巨大的 和 矩阵写出到 HBM,而是在芯片内部极高速的片上共享内存(SRAM)里一气呵成? 阻止这一构想的唯一数学死穴,就是 Softmax 的全局归一化依赖: 标准的 Safe-Softmax 必须经过三趟全局遍历:① 遍历一遍找全局最大值 (防止浮点溢出);② 遍历第二遍求指数和分母 ;③ 遍历第三遍做除法归一化。如果数据被切分成小块,后一块的数据可能出现更大的值,难道前面所有算过的数据都要推翻重算?1. 为什么需要算它?(The Problem)
我们需要一种数学递推机制:当数据像流水一样一小块一小块到达片上 SRAM 时,能动态合并前后的统计量,绝不需要回头重新读取前序数据!2. 物理直觉比喻(Mental Model)
想象两个装有重物的盘子在一个天平上:- 前半截数据算出了一个局部最高峰 和局部分母 ;
- 突然新来了一批数据,冒出了一个更高的峰 ;
- 我们不需要把前面的所有数据找出来重新做减法,只需要把旧的分母 乘以一个衰减因子 ,旧数据的影响力就被立刻“打折校准”到了新的基准线上!
3. 极简手算(Tiny Calculator)
设行向量切为两段: , 。- 先看 A 段:
- 最大值 ;
- 指数和 。
- 后看 B 段:
- 最大值 ;
- 指数和 。
- 合并全局:
- 新全局最大值 ;
- 旧分母 乘以校准项:
- 合并分母:
- 验证全量标准算:
- 全向量 ,全局最大值 5;
- 分母 。
- 完全精确相等!
4. 正式数学递推证明(Formal Proof):
给定行向量被切分为两部分 和 : 新全局最大值为: 全局归一化分母为: 对第一项展开恒等变形: 同理可得第二项: 代入即证: 同样,对于输出累加向量 (设 为对应 段未除分母的中间矩阵乘累加结果): 证毕!只要维护两个极小的标量 和 ,我们就可以在数据流式到达时,以常数级开销瞬间校准历史输出,彻底摆脱全局内存往返读写!1.3 SRAM 分块平铺(Tiling)与片上空间约束方程
在物理硬件上,FlashAttention 将 切分成若干小块,装入 GPU SM 独占的片上共享内存(SRAM / Shared Memory)。- A100 每 SM 共享内存容量:164 KB;
- H100 每 SM 共享内存容量:228 KB;
- 片上 SRAM 带宽高达 19 TB/s(是 HBM 的近 10 倍!)。
- 片上需要同时容纳:
- : ;
- : ;
- : ;
- 中间临时结果与 Double Buffering 缓冲空间。
- 物理约束方程:
2. 第二部分:巅峰迭代——FlashAttention-1、2 到 FlashAttention-3 微架构深拆
从 2022 年到 2024 年,FlashAttention 经历了三次划时代的工程飞跃:2.1 FA-1 到 FA-2:外层循环重排、除法外提与因果掩码短路
FlashAttention-2 能够把执行速度在 FA-1 的基础上硬生生再拔高一倍,核心在于三大手术级的架构刀法:- 外层循环反转(Outer Loop Reversal):
- FA-1:外层循环遍历 分块,内层循环遍历 。为了更新同一个 块的结果,必须不断向全局显存写回未完全归一化的中间输出 ,带来了昂贵的非必要显存同步;
- FA-2:颠覆性反转——外层循环遍历 块,内层循环遍历 块!这意味着一个 块被加载进 SM 的共享内存后,始终驻留在片上,顺畅地扫完所有 块,全部累加结束后,仅执行唯一一次全局显存写回!
- 消灭非必要的局部除法(Delay Scaling):
- FA-1:在内层循环的每一个 Step,都把输出除以当前分母 进行局部归一化,然后在下一步再乘回来,白白浪费了大量乘除法指令周期;
- FA-2:将归一化除法推迟到内层循环完全结束!在循环中只维护未归一化的累加分子,直到最后一步才执行一次标量除法
O = O / l。
- 因果掩码短路(Causal Masking Shortcut):
- 在自回归模型中,下三角矩阵之外全是 0。FA-2 精确计算分块坐标,对于完全处于掩码区域的分块直接跳过不调度计算,算力消耗直接砍半!
2.2 FA-3:Hopper TMA 硬件异步搬运、Warp 角色特化与 FP8 融合
到了 NVIDIA Hopper(H100)架构时代,FlashAttention-3 借助全新专用硬件单元,再次冲破算力天花板:- TMA(Tensor Memory Accelerator)硬件接管搬运:
- 过去:必须由 CUDA 线程通过
LDG指令一条条从显存搬数据,占用大量通用寄存器; - FA-3:仅需发出一条 TMA 描述符指令,硬件 DMA 控制器直接在 HBM 与 Shared Memory 之间建立 5D 空间张量高速直通通道,彻底释放线程算力!
- 过去:必须由 CUDA 线程通过
- Warp Specialization(线程束角色特化):
- 彻底打破“所有线程跑相同逻辑”的传统 SPMD 模式;
- 将 SM 内部的 Warp 划分为 Producer(数据搬运员) 与 Consumer(矩阵乘打手),利用
mbarrier硬件屏障实现零等待交接棒。
- FP8 低精度流水线优化:
- 支持 FP8 GEMM 与 FP32 累加混合精度,将计算吞吐直接翻倍,同时在片上运用量化抗溢出缩放因子保证注意力精度无损。
2.3 FlashDecoding 与 FlashDecoding++:解耦 Decode 极长 KV 序列并发
FlashAttention 虽然神勇,但如果直接套用在 单个 Token 生成的 Decode 阶段,就会遭遇尴尬的并行度不足陷阱:- 在 Decode 阶段,输入 Query 的长度 ;
- 如果序列长度很长(如 32K KV Cache),单个 Head 只能被分配给一个 SM 线程块;
- 现代 GPU 拥有 100 多个 SM(A100 有 108 个 SM,H100 有 132 个 SM),如果 Head 数量较少(如 GQA 只有 8 个 KV Head),会导致大量 SM 核心根本抢不到活干,算力严重饥饿!
- 既然 Query 只有 1,那就沿序列长度(Sequence Dimension)对 KV Cache 进行分块(例如每 256 tokens 切一小段)!
- 将不同的 KV Cache 分块分发给不同的 SM 同时并发计算局部 Softmax 与局部输出;
- 最后通过一个小型的跨 SM Reduce 规约 Kernel,将各块的局部统计量利用 Online Softmax 合并为最终输出!
- 战果:在极长上下文 Decode 场景下,将 GPU 核心利用率瞬间拉满,延迟降低 3~8 倍!
3. 第三部分:宏观全景——大模型 Token 产生的全生命周期与双阶段撕裂
现在,让我们把视线从微观的 Attention 算子移开,上升到大模型整个推理服务的宏观战场:一个 Token 从无到有诞生,系统究竟经历了什么?3.1 两个世界的物理撕裂:Prefill 阶段 vs Decode 阶段
大模型自回归文本生成的物理因果律决定了推理必然分为完全割裂的两幕剧:-
第一幕:Prefill 阶段(首字生成):
- 用户输入一个由 个 Token 构成的 Prompt(如一段长提示词或一份万字财报);
- 所有输入 Token 是已知且同时存在的;
- 机器一次性对这 个 Token 执行全量的并行自注意力计算与 FFN 变换;
- 算子类型是标准的 GEMM(矩阵乘矩阵),计算复杂度 ;
- 这个阶段是典型的 Compute-Bound,瓶颈在于 GPU 的峰值浮点算力(TFLOPs),FlashAttention 在这一阶段能大显身手。
-
第二幕:Decode 阶段(逐字吐出):
- 自回归模型无法未卜先知,第 个 Token 必须依赖第 个 Token 的输出;
- 因此,模型必须进行串行的 一步一循环(Step-by-Step Loop):每次前向计算,输入只有区区 1 个 Token!
- 为了计算这 1 个 Token 的注意力,模型必须从 HBM 中把过去累积的所有几千上万个 Token 的历史 KV Cache 完整搬运出来读一遍;
- 算子退化为 GEMV(矩阵乘向量)。
3.2 为什么自回归 Decode 阶段是“访存地狱”?手算单个 Token 生成代价
为什么算它?(The Problem)
很多工程师问:“既然模型参数量不变,为什么 Decode 阶段速度上不去,核心利用率总是惨不忍睹?”我们用极简数字小算盘(Tiny Calculator) 来手算这笔账。极简手算(Tiny Calculator):
以典型的 LLaMA-2 70B 模型(FP16,权重大小 140 GB) 单卡/多卡推理为例(设单步 Batch=1):- 产生 1 个 Token 的计算量(FLOPs): 前向乘加约为 ;
- 产生 1 个 Token 必须搬运的内存字节数(Bytes): 权重参数必须从 HBM 全部读入片上计算一遍,即读取 140 GB 权重数据(暂且忽略 KV Cache);
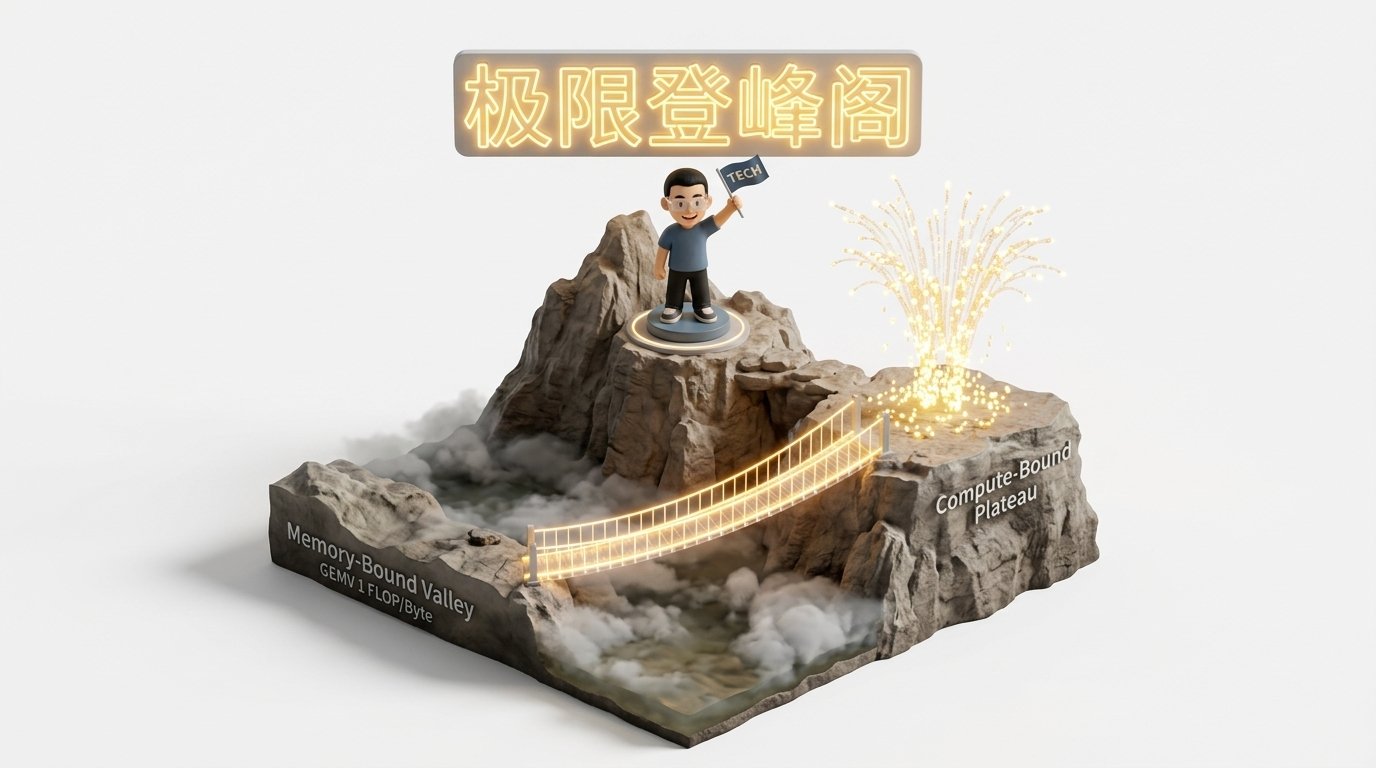
- Decode 阶段的算术强度(Operational Intensity):
硬件残酷现实对比(Sanity Check):
- 回想 A100 的拐点算术强度是 156 FLOPs/Byte;
- 当前算术强度只有 1.0 FLOPs/Byte,足足低于硬件拐点 150 倍以上!
- 在 2 TB/s 的 A100 显存带宽下,读取完 140GB 权重理论物理极限耗时为:
- 在这 70 毫秒里,强大的 Tensor Core 仅仅做了 140 GFLOPs 的运算,其实际利用率只有:
4. 第四部分:端到端 Token 生成全链路核心优化矩阵
面对自回归生成的物理泥潭,现代 AI Infra 架构师们构建了一套立体化的端到端全链路性能优化矩阵: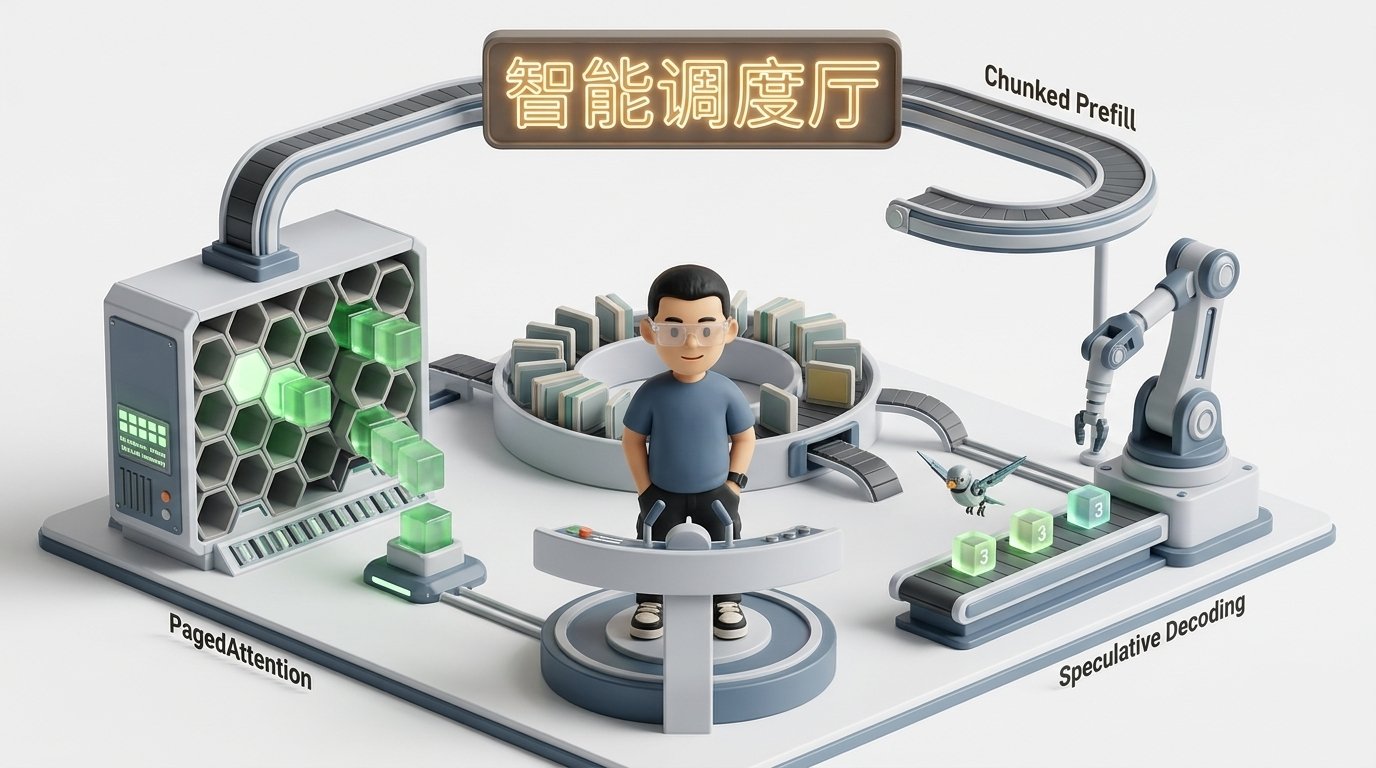
4.1 显存组织优化:PagedAttention 虚拟分页与内存零碎片管理
在早期推理系统中,为了存储自回归过程中不断膨胀的 KV Cache,系统必须按模型的max_seq_len(如 4096 或 8192)为每个请求预先分配一块连续的显存大块。
- 痛点:大量请求可能只生成 50 个 Token 就退出了,提前预占的数 GB 显存被彻底浪费;同时产生了严重的显存外部碎片;
- 真实生产测算:传统系统的有效显存利用率仅有 20%~40%,60% 以上的显存全是泡影!
- 借鉴操作系统虚拟内存分页哲学:
- 将显存划分为固定大小的 物理块(Physical Blocks)(例如每个 Block 容纳 16 个 Token 的 KV 向量);
- 为每个请求维护一张动态映射表 BlockTable;
- 只有当请求生成到新的 16 个 Token 时,才向公共显存池申请一个新的 Block,按需分配、物理不连续、逻辑连续!
- 收益:显存浪费降至 4% 以下,单机推理并发量直接翻倍甚至提升 3~4 倍!
4.2 架构层演进:MHA ➔ MQA ➔ GQA ➔ DeepSeek MLA 低秩压缩
既然 Decode 阶段的死穴是 HBM 显存带宽,那么在模型架构设计上直接砍掉 KV Cache 的体积,就是最高维的减重解法:- MQA(Multi-Query Attention):所有 Query Head 强制共享同一组 Key/Value Head,KV 显存搬运量瞬间缩减为原先的 ( 为头数,通常为 32 或 64);
- GQA(Grouped-Query Attention):如 LLaMA-3、Mistral,将 32 个 Q 头分为 8 组,每组共享 1 对 KV 头,兼顾模型泛化精度与推理吞吐;
- DeepSeek MLA(Multi-Head Latent Attention):DeepSeek-V2 / V3 的神来之笔。不再缓存庞大的 KV 向量本身,而是在上层通过低秩矩阵将 KV 压缩为一个仅数百维的 潜变量(Latent Vector ),在片上计算时再用小矩阵现场解压。Decode 阶段的 KV 显存搬运量暴跌一个数量级,创造了吞吐神话!
4.3 调度机制革命:连续批处理(Continuous Batching)消除气泡
传统静态批处理(Static Batching)在遇到长短不一的生成请求时,必须遵循“木桶原理”:一个批次里的 4 个请求,就算有 3 个在第 50 步就生成完了,也必须陪着第 4 个请求干等到第 2000 步! 这导致严重的 GPU 空转气泡。 连续批处理(Continuous / In-flight Batching):- 迭代级调度(Iteration-level Scheduling);
- 每一个 step 执行完毕,一旦检测到某个请求生成了
[EOS]结束符,立即将其移出当前批次,释放其 KV Block; - 同时在下一个 step 的缝隙中,瞬间把等待队列里的新请求拉入批次填补空缺;
- 像一辆“招手即停、到站即下”的极速公交,将 GPU 利用率从 30% 稳稳拉升至 80% 以上!
4.4 阶段冲突化解:分块预填充(Chunked Prefill)与算子时间片交织
当长 Prompt(Prefill)与短 Decode 混跑在同一个 Continuous Batch 实例中时,会爆发致命冲突:- 一个 16K 的长 Prefill 请求跑一次矩阵乘需要 2 秒;
- 这会导致同一批次里的其他 100 个正在逐字吐字的 Decode 请求被硬生生卡住 2 秒钟,引发严重的 P99 延迟毛刺与打字机卡顿!
- 将庞大的 16K Prompt 拆分为固定大小的 Chunk 片段(如每次只吞 512 Tokens);
- 在每一个调度 Iteration 中,模型同时执行:
- 通过将 Prefill 算子与 Decode 算子融合在一次前向 GEMM 中,既抹平了 P99 延迟尖峰,又顺带拉升了算力利用率!
4.5 算法突破物理串行:投机采样(Speculative Decoding)机制
大模型自回归最让人绝望的,是无论硬件多强,每次前向计算只能吐出 1 个 Token 的物理串行性。 投机采样(Speculative Decoding)的降维打击:- 核心直觉:“既然想得慢、验证快,何不让小弟先猜,大哥一次性批量批卷?”
- 两阶段机制:
- Draft 阶段(草稿小模型):用一个极轻量的小模型(如 1B 参数),以极高速度连续自回归“猜”出接下来的 个 Token(如 );
- Target 阶段(主模型校验):大模型(如 70B)将这 个猜出来的 Token 与原始输入拼接,仅仅做一次标准的前向矩阵乘(一次 Prefill 模式验证),同时计算出这 个位置的真实概率分布;
- 验收接受(Rejection Sampling):大模型按概率严格校验,如果前 3 个猜对了,第 4 个猜错了,则接受前 3 个并修正第 4 个;
- 收益:大模型仅执行了一次前向计算的时间,就实际产出了 3~4 个 Tokens!在完全不损失任何数学精度(Lossless)的前提下,实现 2~3 倍的纯延迟加速!
4.6 算力网拓扑解耦:Prefill-Decode(PD)物理分离架构
在超大规模集群中,将 Prefill 与 Decode 混部在同一台机器上,终究存在硬件资源特性的天然错配:- Prefill 极度渴望高 TFLOPs 算力;
- Decode 极度渴望大显存容量与高 HBM 读写带宽。
- 物理机群切分:
- Prefill 专享节点:配置单卡浮点算力极高、性价比高的计算型 GPU(追求高吞吐算力利用率);
- Decode 专享节点:配置 HBM 显存极大、带宽极高的访存型 GPU,加载全部权重与 PagedAttention 显存池;
- 高速算网连接:Prefill 节点算完 Prompt 的 KV Cache 后,通过 8x400G RoCEv2 / RDMA 专网直接将 KV Cache 内存切片无感流式推送到 Decode 节点的显存中!
- 战果:彻底消除互相干扰,使得每个节点的算力或显存利用率均达到 90% 以上的理论极限!
5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
以下提供 3 个完全独立、无第三方隐式依赖的工业级高保真 Python 实验脚本,带你亲自在本地验证本章所有核心算法。实战 1: 高保真 Python / NumPy 复现 FlashAttention-2 核心分块与 Online Softmax
本实验手写一个轻量高保真 FlashAttention-2 前向算法仿真,严格复现外层循环反转、Online Softmax 动态局部衰减与除法外提,并与标准 Attention 对比精度。实战 2: PagedAttention 显存池与虚拟物理映射仿真器
本实验用简洁高内聚代码模拟 vLLM 核心的 PagedAttention 块管理器:观察定长 Block 分配、逻辑块到物理块解耦与显存零外部碎片特性。实战 3: Continuous Batching 连续批处理调度引擎压测仿真
本实验模拟在动态请求流下,对比传统 Static Batching(静态批处理) 与 Continuous Batching(连续批处理) 的运行效率,量化验证“招手即停”消除空转气泡的巨大威力。6. 第六部分:生产落地避坑指南与黄金准则
6.1 Token 生成端到端调优核心避坑矩阵
6.2 生产级 LLM Serving 性能工程黄金 Checklist
- 1. 【算子选型对齐】 Prefill 阶段统一强制开启 FlashAttention-2 或 FlashAttention-3(Hopper 架构),严禁使用原生 PyTorch 矩阵乘 Attention。
- 2. 【解码并发解耦】 针对 8K 以上的长上下文生成请求,配置开启 FlashDecoding,解耦 KV Cache 序列维度的 SM 核心并行度。
- 3. 【显存分页标配】 生产推理引擎(如 vLLM)底座必须启用 PagedAttention,Block Size 建议设为 16 或 32,消除显存外部碎片。
- 4. 【连续批处理启用】 确认 Serving 引擎处于 Iteration-level Continuous Batching 模式,严禁使用固定请求等待的静态批处理。
- 5. 【Chunked Prefill 削峰】 对长文本业务(输入 > 4K)配置
max_num_batched_tokens(通常建议 512 或 1024),强制实施分块预填充,平滑 P99 延迟毛刺。 - 6. 【架构选型倾向】 新模型架构选型优先评估 GQA(如 LLaMA-3)或 MLA(DeepSeek),显存带宽消耗降低 80% 以上。
- 7. 【投机采样场景准入】 在文本润色、翻译、摘要等平滑生成场景部署 Speculative Decoding,并实时监控草稿接受率,低于 65% 时自动熔断降级。
- 8. 【显存水位防护线】 将 KV Cache 显存占用上限锁定在物理显存的 85%~90%,保留 10% 裕量给系统动态开销,坚决避免触发 OOM 宕机。
- 9. 【SLO 刚性双指标监控】 监控大屏必须分别监控 TTFT(首字时间)与 TPOT(逐字时间),出现背离时快速定位是算力瓶颈还是显存带宽瓶颈。
- 10. 【PD 分离演进评估】 当集群总算力规模达数十卡且存在极长文本检索时,评估落地 Prefill-Decode 物理分离集群,释放异构硬件最大效能。
7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 1. 为什么标准 Attention 的显存读写复杂度是 ,而 FlashAttention 能将其彻底降至 ?
- 2. 在面试白板上手推 Online Softmax 动态更新公式,并证明旧分母乘上衰减项后为什么与全局计算等价?
- 3. FlashAttention-2 相比 FlashAttention-1 最大的循环反转改动是什么?消除了什么物理开销?
- 4. FlashAttention-3 利用了 NVIDIA Hopper 架构的哪些专有硬件单元(如 TMA 与 Warp Specialization)?
- 5. 为什么在单 Token 生成的 Decode 阶段,FlashAttention 无法完全打满 GPU 核心利用率?FlashDecoding 如何解决?
- 6. 详细手算:为什么 LLaMA-70B 在 Batch=1 Decode 阶段的算术强度只有约 1.0 FLOP/Byte?
- 7. 说明 PagedAttention 的 BlockTable 映射机制,它是如何消灭传统预分配模式中 60% 以上的显存碎片的?
- 8. 连续批处理(Continuous Batching)相比传统静态批处理在调度粒度上有何本质飞跃?
- 9. 什么是 Chunked Prefill?为什么将长 Prompt 切片能大幅压制 Decode 过程中的 P99 延迟毛刺?
- 10. 投机采样(Speculative Decoding)是如何在不损失任何生成精度的前提下打破自回归串行物理限制的?
7.3 3 道高阶开放式课后思考题
- DeepSeek MLA 低秩潜变量对算子与访存的终极重塑:DeepSeek-V2/V3 提出的 MLA 架构仅缓存数百维的压缩向量 ,在计算 Attention 时现场还原。请从 GPU 显存带宽(GB/s)与 SRAM 片上算力(TFLOPs)的 Trade-off 角度,推导为什么这种“增加局部小矩阵乘解压运算以极端压缩 HBM 显存读写”的策略,在超大并发 Decode 场景下能带来数倍的系统净加速?
- PD 分离架构中的跨机传输吞吐平衡:在 Prefill-Decode 分离架构中,Prefill 节点算出的 KV Cache 必须通过网络推送给 Decode 节点。设 Prompt 长度为 32K,Batch=4,FP16 存储,单次生成的 KV Cache 体积有多大?若采用 400Gbps 物理网络,纯网络传输耗时是多少?当输入多长时,网络传输时间会反超 Prefill 本身的计算时间?
- 极端长上下文(1M Tokens)下的算子与系统组合极限:如果模型的输入上下文达到 1,000,000(1M)Tokens,单台机器物理显存已经无法装下全部 KV Cache。此时应该如何联合编排 FlashAttention、Context Parallelism(Ring-Attention)、PagedAttention 与主机内存/NVMe 换页策略?
8. 第八部分:知识库与权威论文证据溯源
本实战项目所有微架构原理、算力显存账本推导与调度机制均严格溯源于以下开源工程源码与学术奠基文献:- FlashAttention 官方开源源码与论文矩阵:
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (Tri Dao et al., NeurIPS 2022);
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning (Tri Dao, 2023);
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision (Jay Shah, Tri Dao et al., 2024);
- 参考本地知识库:AI_BOOK/LeetCUDA/kernels/。
- vLLM 生产级推理引擎与调度系统:
- Efficient Memory Management for Large Language Model Serving with PagedAttention (Woosuk Kwon et al., SOSP 2023);
- 参考本地知识库:AI_BOOK/AI-fundamentals/09_inference_system/ 与 AI_BOOK/AIInfraGuide/docs/guides/模块四-推理优化/。
- 投机采样与长上下文前沿突破:
- Fast Inference from Transformers via Speculative Decoding (Leviathan et al., ICML 2023);
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model (DeepSeek-AI, 2024)。
附录:Appendix A — 大厂高频白板推导面试真题深度破局
Q1: 在面试白板上手推:Online Softmax 是如何在不需要全局最大值的前提下,动态更新局部归一化分母的?给出严密的递推证明。
Ringi 考官拆解与满分回答:- 定义局部统计量: 设行向量被切为两段 和 。已知已算出 段局部统计量:
- 合并全局最大值:
- 分母严密展开与校准:
Q2: 为什么自回归大模型在 Decode 阶段无法跑满 GPU 的 Tensor Core 算力?请给出算术强度的定量推导。
Ringi 考官拆解与满分回答:- GEMM 与 GEMV 的算术强度天壤之别:
- Prefill 阶段(GEMM):输入序列为 ,计算复杂度为 ,而权重只需要从显存加载一次,算术强度正比于 (当 时算术强度达数千),属于典型的 Compute-bound;
- Decode 阶段(GEMV):每一步前向输入只有 1 个 Token!为了计算这 1 个 Token,模型必须将全量权重参数从 HBM 逐层读入片上计算。
- 定量算术强度推导:
设模型参数量为 (以 FP16 存储,即 字节)。
- 单 Token 计算量:乘加各一次,总浮点运算次数 FLOPs;
- 单 Token 权重显存读取量: Bytes;
- 基础算术强度为:
- 硬件对比与瓶颈判定:
- A100 的拐点算术强度为 ;
- Decode 的实际算术强度( )距离硬件饱和点足足差了 150 倍以上!
- 核心结论:系统处于极度的 Memory-bound(访存受限) 状态,总线读写带宽被打满,而计算核心绝大部分时间处于空闲死等数据的状态。
Q3: 详细阐述 PagedAttention 与 Continuous Batching 如何协同实现推理吞吐翻倍的微架构与调度机制。
Ringi 考官拆解与满分回答:- 分工协作定位:
- PagedAttention 管 “显存怎么存”:将 KV Cache 划分为不连续的定长物理块(如 16 tokens/block),按需分配,从底层消灭了内部与外部显存碎片(将浪费从 60% 压制到 4% 以内);
- Continuous Batching 管 “请求怎么排”:在 Iteration 迭代级别进行调度,有请求结束立刻退位并释放其占用的 KV 物理块,等待队列中的新请求即时补位。
- 两者的相乘效应(Synergy):
- 如果只有 Continuous Batching 而没有 PagedAttention:请求退出后留下的显存是由于定长预分配造成的连续大坑,新来的请求尺寸不匹配无法利用,产生严重外部碎片,调度器依然无法插空;
- 如果只有 PagedAttention 而没有 Continuous Batching:显存池虽然灵活,但整批请求依然要陪最慢的一个空转到最后,GPU 计算气泡依然无法消除;
- 最终结论: 正是因为 PagedAttention 提供了微观粒度的即时块回收与分配弹性,Continuous Batching 才能在宏观上做到毫秒级的随退随补,二者结合直接将系统并发度与 GPU 利用率拉升数倍!